
5.4 微调与 LoRA
核心问题: 微调改变什么,LoRA 又减少了哪些训练成本?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
SFT 的训练方式
监督微调(Supervised Fine-Tuning,SFT)使用“指令—回答”样本继续训练语言模型:
[指令] 将 "Hello, world!" 翻译成中文。
[回答] 你好,世界!
训练通常仍使用 token 交叉熵,只对回答部分计算损失:
输入:[指令 tokens][回答 tokens]
标签:[忽略       ][回答 tokens]
SFT 可以调整任务行为、输出格式、术语使用,也可能让模型记住训练样本中的事实。它不保证新增知识能被稳定调用,也不适合频繁更新或需要来源追溯的知识;这类需求通常更适合 RAG 或外部工具。
全量微调与参数高效微调
全量微调更新所有权重,显存中还需保存梯度和优化器状态。它提供较大的参数更新空间,但训练、存储和版本管理成本较高,也可能使原有任务表现下降。
参数高效微调(PEFT)只训练新增或选定的一小部分参数。LoRA 是常用方法之一。
LoRA
对于原权重
其中
而原矩阵参数量为
训练完成后,可将
低秩更新是一种容量约束,不保证等价于全量微调。rank、目标模块、数据量和任务差异都会影响结果,应把全量微调或未微调模型作为基线。
选择训练起点
| 起点 | 适用情况 | 主要风险 |
|---|---|---|
| Base 模型 | 需要自行建立指令行为,且有足够数据与评测 | 数据和训练成本高 |
| Instruct 模型 | 已有对话能力,只需适配任务或格式 | 原有对齐行为可能与任务冲突 |
选择具体模型时,检查:
- 任务和语言在未微调模型上的基线;
- tokenizer、上下文长度和输入模态;
- 显存、吞吐与推理框架支持;
- 权重许可证与数据许可;
- 是否有稳定版本和可复现的评测结果。
模型系列更新很快,不在本节维护固定“推荐名单”。
对齐 SFT 与任务微调
两者使用相似训练方法,区别在数据目标:
| 类型 | 数据范围 | 评价重点 |
|---|---|---|
| 通用指令 SFT | 多任务指令与回答 | 指令遵循、通用能力、安全行为 |
| 任务微调 | 特定领域或固定输出任务 | 任务指标、格式正确率、能力保持 |
“通用助手”和“领域模型”不是严格的训练阶段边界。同一数据集也可能同时改变格式、领域术语和回答偏好。
微调前先判断瓶颈
- 提示词已能完成任务,只需固定模板:先改 Prompt 和输出校验。
- 答案依赖频繁更新或私有资料:先评估 RAG。
- 需要稳定学习特定格式、分类边界或行为:评估微调。
- 需要调用系统并根据结果继续执行:评估工具调用或 Agent 流程。
微调后要同时检查目标任务、未参与训练的相邻任务和安全集,避免只报告训练集或单一平均分。
代码实验
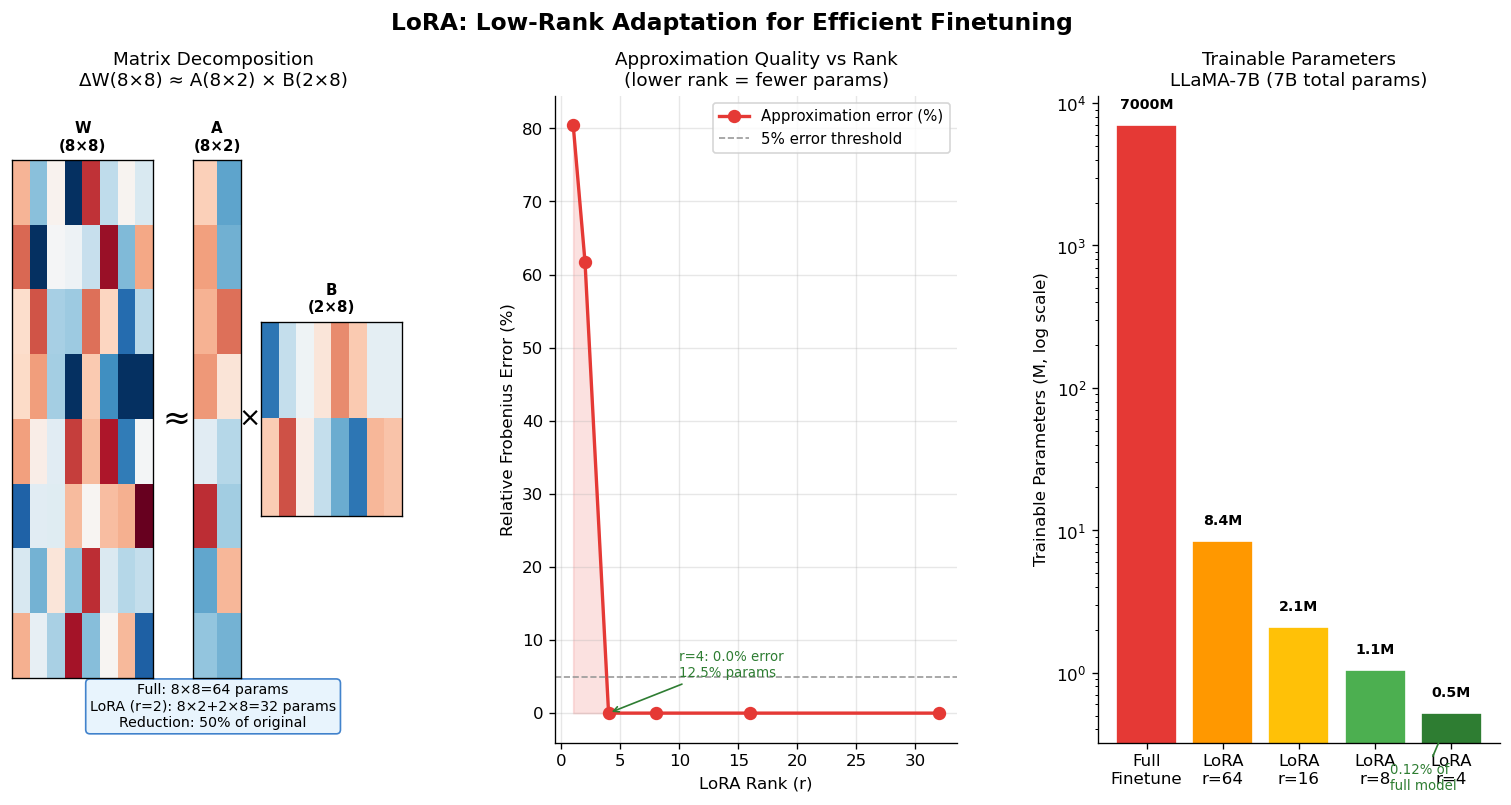
图5.4:冻结原权重并训练低秩矩阵
代码文件: code/ch05_llm_basics/lora_visualization.py
运行方式: python code/ch05_llm_basics/lora_visualization.py
改变 rank 和目标矩阵尺寸,计算可训练参数量及其占比。
本节小结
- SFT 用回答 token 的监督损失调整模型行为,也可能记忆训练样本。
- LoRA 用低秩矩阵限制可训练参数量,但效果需要与基线实测。
- Prompt、RAG、微调和 Agent 解决的瓶颈不同,应先定义任务与指标再选择方法。
扩展阅读: 微调方法调研下一节: 5.5 偏好对齐:SFT、RLHF 与 DPO