
2.1 梯度下降
核心问题: 如何用局部梯度迭代降低目标函数?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
优化问题
给定参数
给出当前位置附近目标增长最快的方向。基本更新为:
链式法则与反向传播
当计算由多步函数组成时,链式法则把输出对中间变量的导数组合起来:
反向传播是反向模式自动微分在计算图上的实现。一次反向过程可以复用中间结果,得到所有可训练参数的梯度;它负责计算梯度,优化器负责使用梯度更新参数。
学习率
- 过小:单步变化小,达到同一损失需要更多更新;
- 过大:可能跨过低损失区域并产生振荡或发散;
- 合适:损失在可接受步数内下降,同时验证指标保持稳定。
“合适”取决于目标函数尺度、批大小、优化器和调度策略。不能仅从某个固定默认值推断。
三种梯度估计
| 方法 | 每次更新使用的数据 | 特点 |
|---|---|---|
| Batch GD | 全部训练集 | 梯度确定,但单步成本高 |
| SGD | 单个样本 | 更新频繁,方差大 |
| Mini-batch GD | 一批样本 | 适合向量化计算,是常见训练方式 |
若损失按批内样本取平均,小批量更新为:
梯度累积可以扩大有效批大小,但归一化、随机层和学习率调度的更新时机可能使它与单次大批量并不完全相同。
代码实验
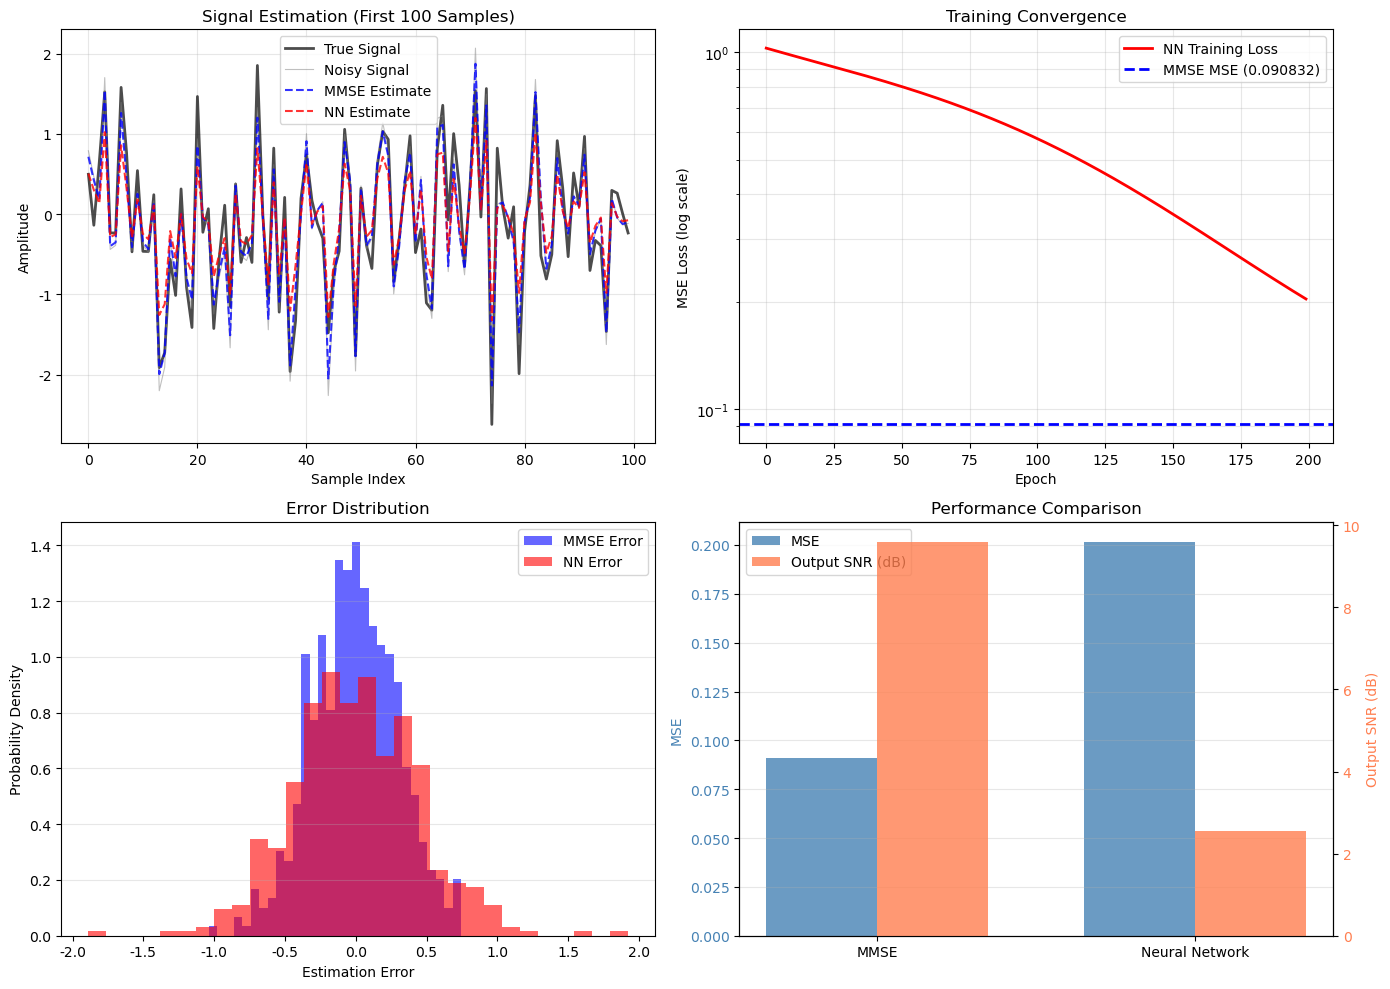
图2.1:线性 MMSE 估计器与神经网络在同一模拟任务上的误差。结果反映当前数据、模型和训练配置。
代码文件: code/ch02_optimization/mmse_vs_nn.py
bash
python code/ch02_optimization/mmse_vs_nn.py修改学习率或训练步数,记录训练损失、测试误差和是否出现数值异常。不要只用收敛速度判断模型优劣。
本节小结
- 梯度描述目标函数的局部变化,学习率控制更新步长。
- 反向传播计算梯度,梯度下降使用梯度更新参数。
- 批量方式影响梯度方差、单步成本和硬件利用率。
下一节: 2.2 自适应优化器