
2.5 线性回归与逻辑回归
核心问题: 连续值预测和二分类如何写成可优化的问题?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
线性回归
给定输入
进行预测。常用均方误差为:
其梯度为:
参数可用闭式解或梯度方法估计。线性回归只能直接表示输入特征的线性组合;加入多项式等变换后,模型对变换后的特征仍是线性的。
逻辑回归
二分类时,逻辑回归先计算线性分数,再用 Sigmoid 转为概率:
常用二元交叉熵为:
其梯度为:
逻辑回归输出概率,但决策边界在原始特征空间中仍是线性的。
两者的区别
| 方面 | 线性回归 | 逻辑回归 |
|---|---|---|
| 任务 | 连续值预测 | 二分类 |
| 输出 | 任意实数 | 0 到 1 的概率 |
| 常用损失 | 均方误差 | 二元交叉熵 |
| 决策边界 | 不适用 | 线性超平面 |
正则化、特征尺度和数据异常值都会影响拟合结果。训练分数不能替代测试集或交叉验证结果。
与神经网络和语言模型的连接
神经网络中的全连接层也是线性映射
语言模型的输出层把隐藏表示映射为词表上的 logits,再用 Softmax 得到下一个 token 的条件分布:
这与逻辑回归共享“线性分数 + 概率归一化 + 交叉熵”的形式,但语言模型还包含产生
代码实验
实验同时展示线性回归拟合、逻辑回归决策边界和损失曲线。
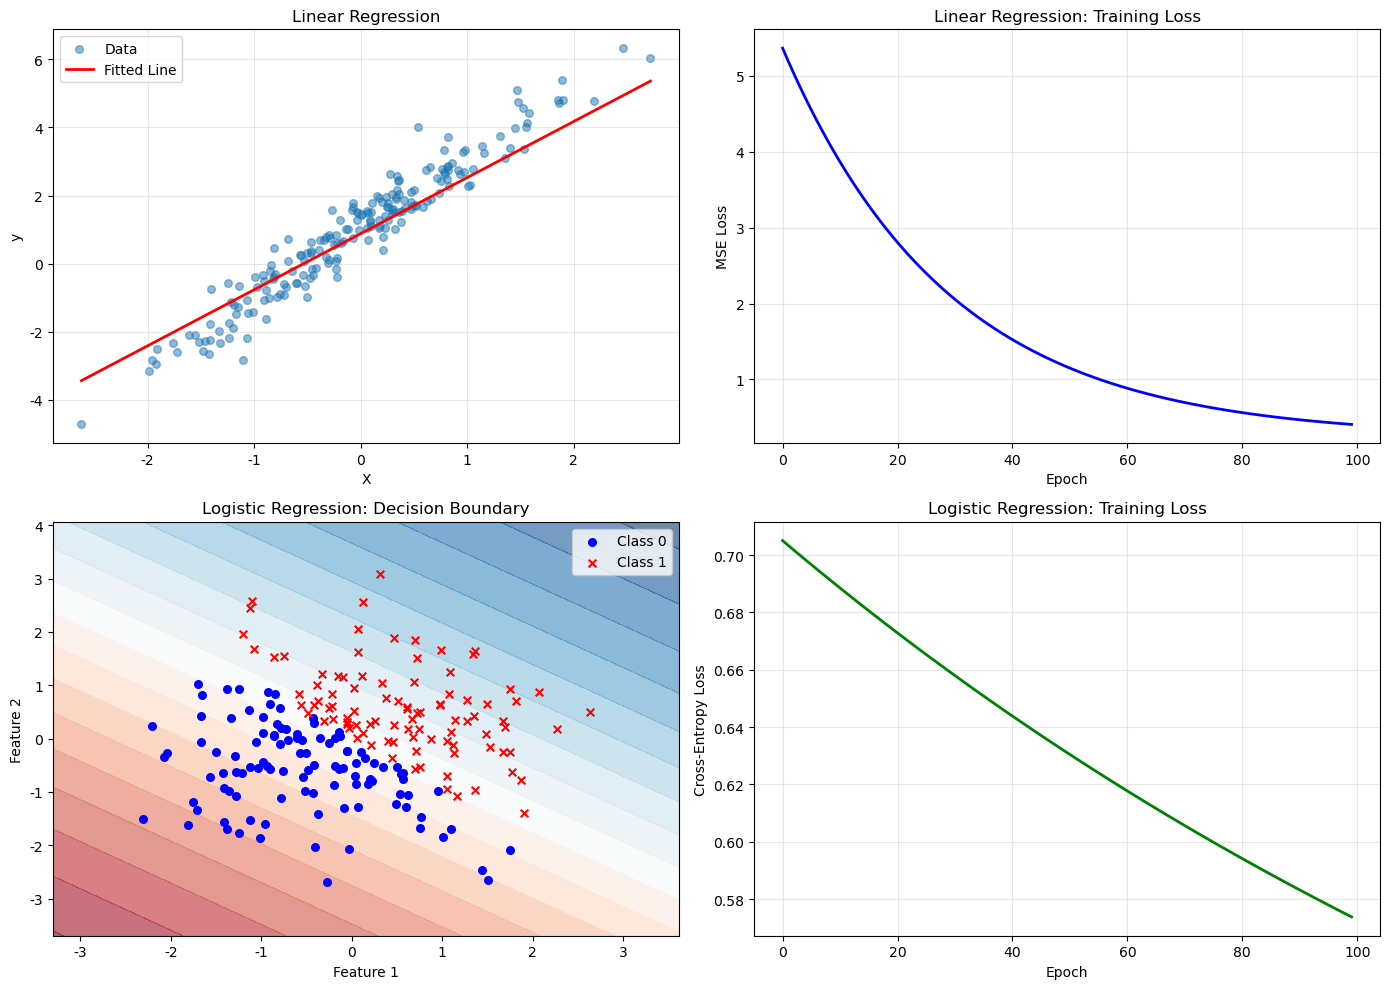
图2.5:连续值拟合与二分类的输出、损失和决策边界。
代码文件: code/ch02_optimization/linear_logistic_regression.py
运行方式: python code/ch02_optimization/linear_logistic_regression.py
运行后改变特征尺度或学习率,观察损失曲线和边界是否变化。
本节小结
- 线性回归预测连续值,逻辑回归估计二分类概率。
- 模型、损失和优化器是三个不同选择。
- 语言模型输出层沿用了多分类线性头与交叉熵,但隐藏表示来自更大的网络。
下一节: 2.6 支持向量机与核方法