
扩展:凸分析基础
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
所属章节: 第 2 章:优化与机器学习
凸性提供的是一组有条件的结构保证:如果问题满足凸性,任何已经存在的局部最优都是全局最优;但凸性本身不保证最优解一定存在、唯一,也不保证任意算法都能找到它。
凸集
集合
几何上,集合内任意两点之间的线段仍在集合内。
常见凸集包括欧氏球、半空间、仿射子空间以及凸集的任意交集。两个凸集的并集不一定是凸集。
凸函数
定义在凸集
一阶与二阶条件
若
若
是凸性的充要条件。
| 函数 | 性质 | 定义域 |
|---|---|---|
| 凸 | ||
| 严格凸 | ||
| 严格凹 | ||
| 凸 |
严格凸函数至多有一个全局最优点,但仍需可行域、连续性或强制性等条件保证最优点存在。
凸优化问题
一个常见标准形式是
其中目标
能保证什么
- 任一局部最优点都是全局最优点。
- 如果最优解存在,最优解集合是凸集。
- 一阶最优性条件在适当可微或次梯度条件下可用于判定全局最优。
不能直接保证什么
- 存在性: 例如
的下确界是 0,但没有有限 取得它。 - 唯一性: 常数目标或非严格凸目标可能有多个全局最优点。
- 算法收敛: 梯度下降还需要光滑性、步长和最优解存在等条件。
- 求解成本: 问题维度、约束结构和条件数仍会影响计算难度。
线性规划、半正定规划、带半正定二次项的二次规划,以及固定特征下的逻辑回归,都是常见凸问题。
梯度下降的条件化结论
对无约束、可微且梯度为
这些结论不能缩写成“凸函数上梯度下降必然收敛”:非光滑目标、错误步长、约束处理不当或最优解不存在时,需要其他分析。
对偶问题
对问题
Lagrangian 为
对偶函数
总是给出原最小化问题最优值的下界,这称为弱对偶。对于满足适当约束资格条件(例如 Slater 条件)的凸问题,原问题与对偶问题最优值相等,即强对偶。凸性本身不自动推出强对偶。
与深度学习的关系
深度网络训练通常关于全部参数是非凸的。原因不是简单地“激活函数非凸”:即使使用某些凸激活,多层参数之间的乘积、缩放对称性和组合结构也会使联合参数化非凸。
非凸意味着凸问题的全局保证不再通用,但不能由此推出:
- 一定存在很多差的局部最优;
- 梯度法一定会停在局部最优;
- 过参数化一定更容易优化或一定能够泛化。
实际训练还会遇到鞍点、平坦方向、尺度不适定和随机梯度噪声。优化结果取决于架构、初始化、数据、归一化、优化器和训练预算,应通过独立验证集与多次运行评估。
逻辑回归与神经网络的对照
| 方面 | 固定特征的逻辑回归 | 多层神经网络 |
|---|---|---|
| 参数化 | 线性 logits | 多层组合 |
| 常用交叉熵目标 | 关于权重凸 | 通常关于全部参数非凸 |
| 局部最优 | 若存在则是全局最优 | 不具备通用保证 |
| 算法结论 | 仍依赖步长、光滑性和数据 | 依赖更多工程与统计条件 |
凸优化并不天然“表达能力有限”,非凸也不天然“效果更好”。凸性描述优化结构,表达能力则由函数族、特征和约束共同决定。
实验:观察结构而不是证明普遍结论
运行:
python code/ch02_optimization/convex_analysis_demo.py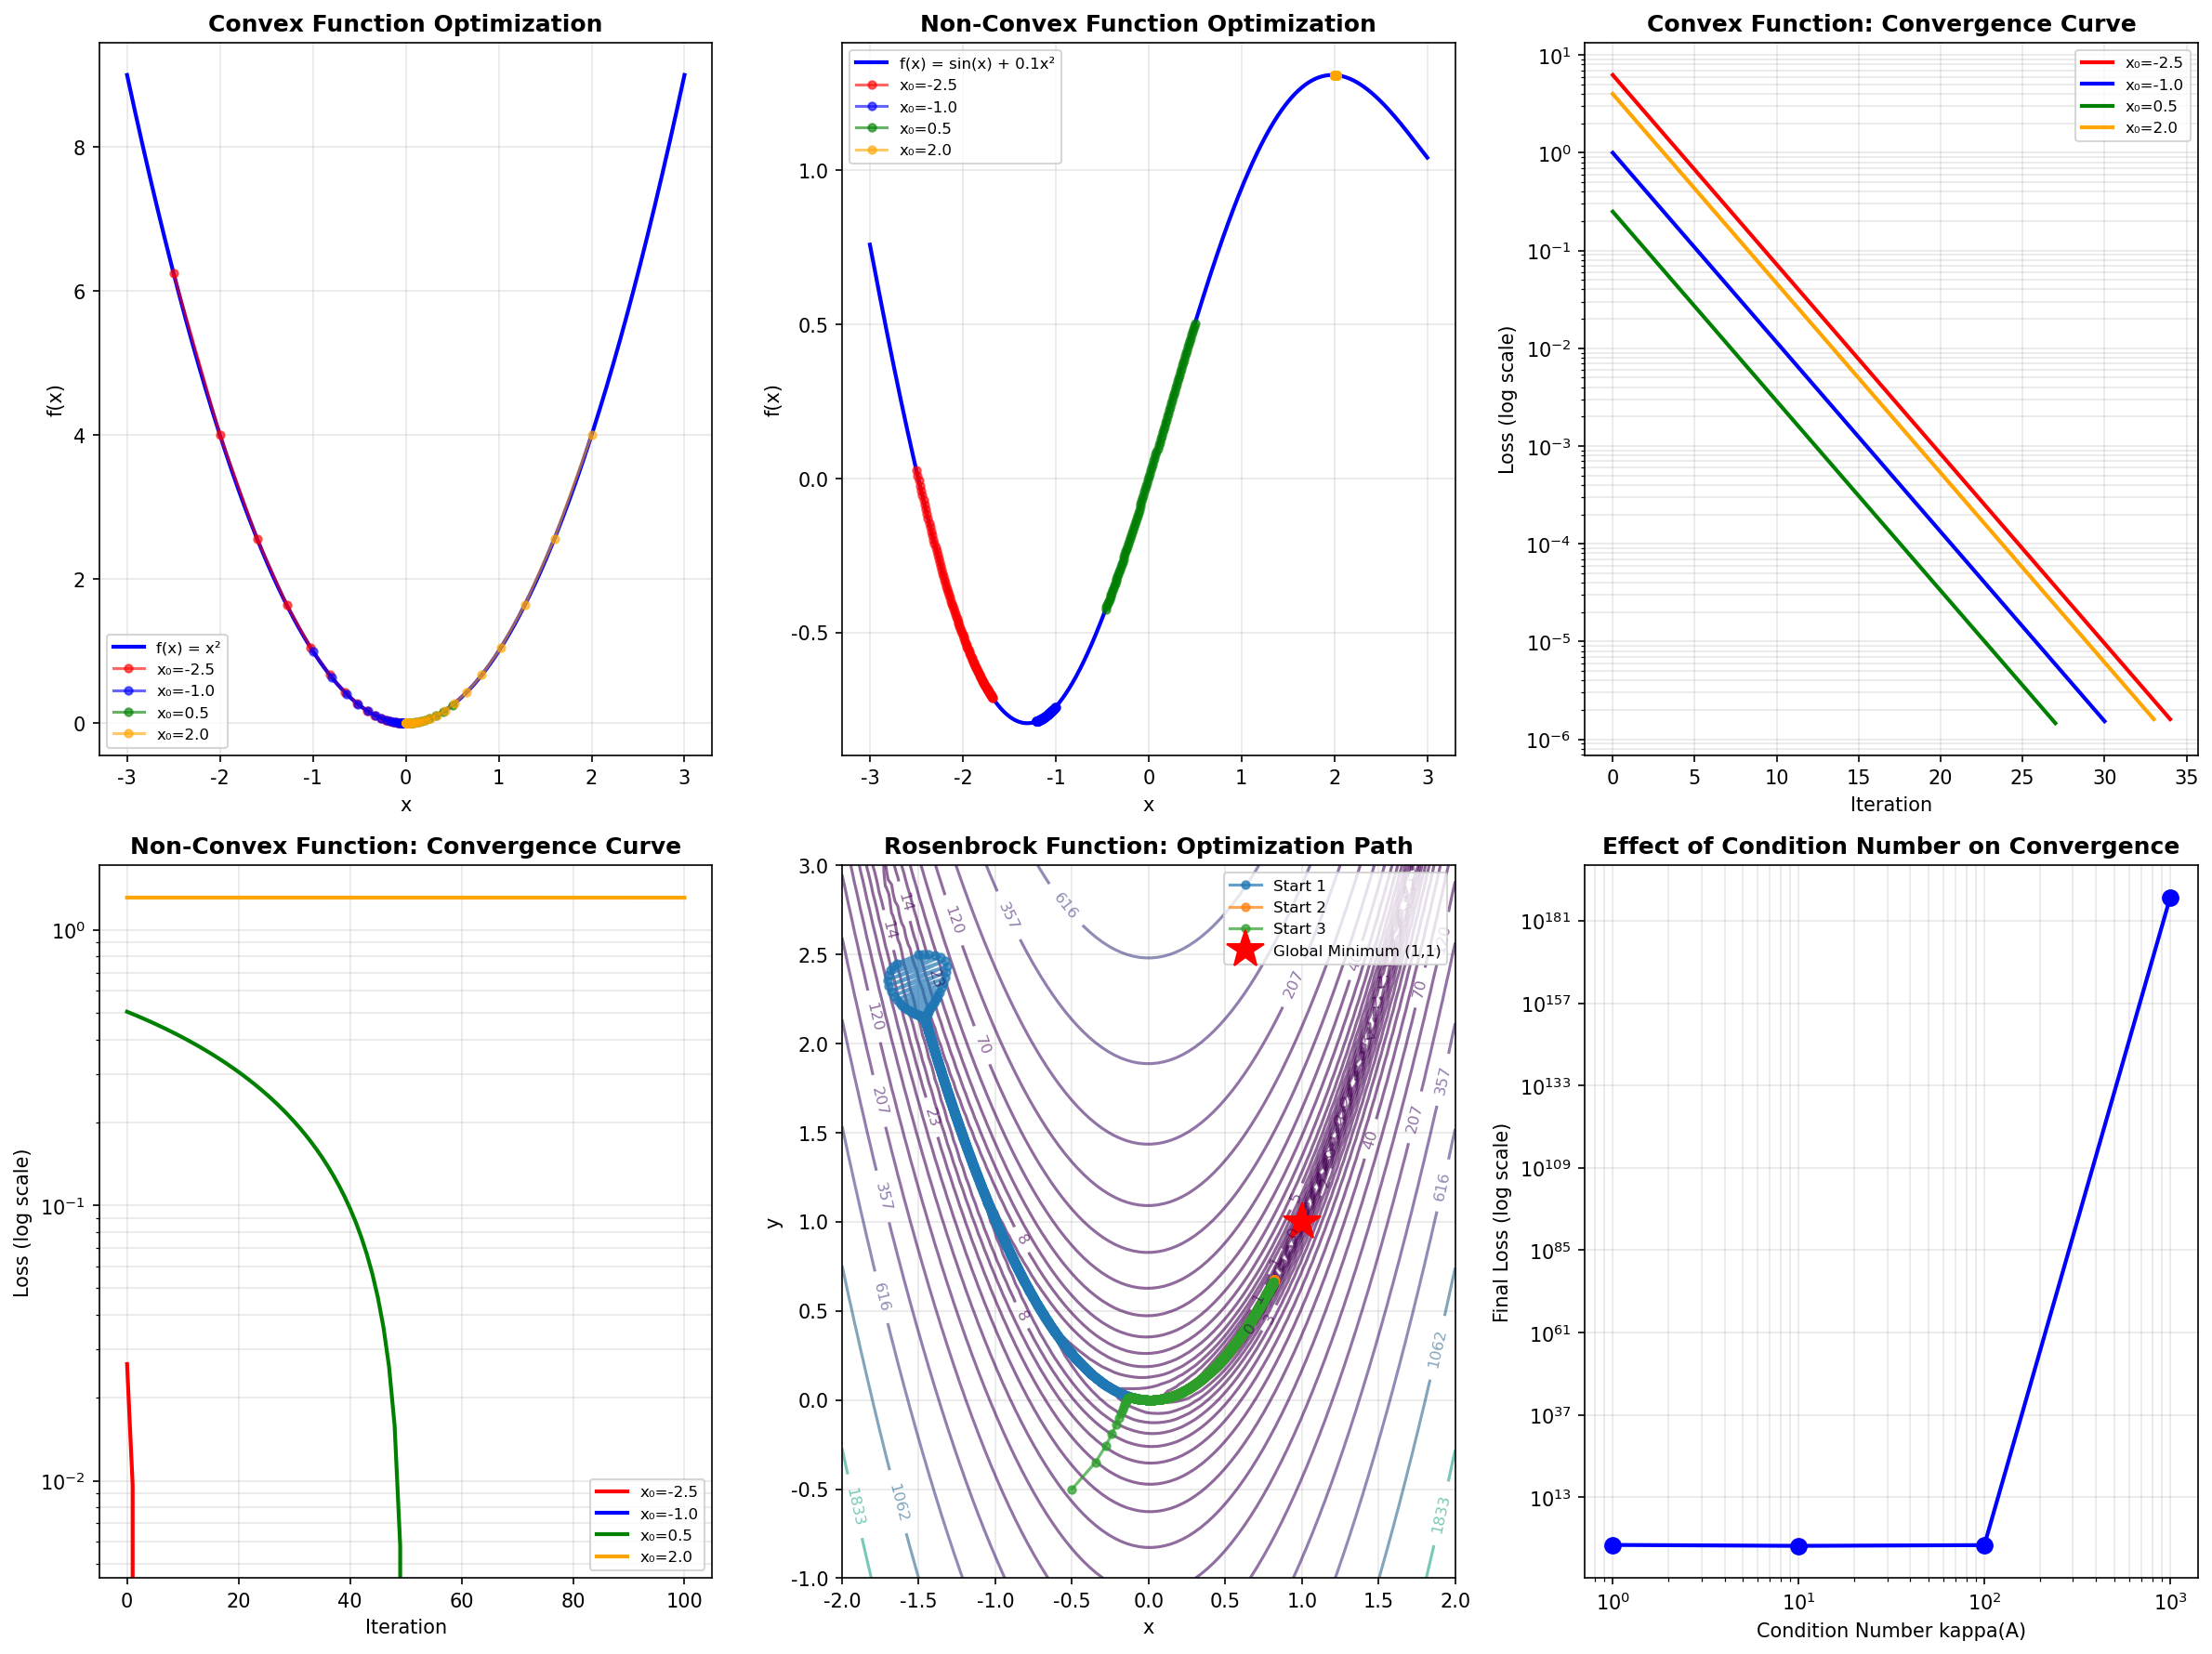
图:凸函数与非凸函数的优化路径、Rosenbrock 等高线以及条件数对梯度下降的影响。一次轨迹只能展示当前函数、初始化和步长下的行为。
实验时建议记录:
- 目标函数和可行域是否满足凸性;
- 初始化、步长和停止条件;
- 梯度范数、目标值和是否出现数值异常;
- 改变条件数后收敛速度如何变化。
进一步阅读
- 2.1 梯度下降
- 2.4 数值方法
- 高级优化
- 附录 A:数学与符号参考
- Boyd & Vandenberghe, Convex Optimization
- Nesterov, Introductory Lectures on Convex Optimization
返回: 第 2 章:优化与机器学习