
5.3 模型家族与选型
核心问题: 面对不同模型,应该比较什么,而不是记住什么?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
模型名称不是选型依据
GPT、Llama、Qwen、Mistral、DeepSeek、Claude 和 Gemini 等名称代表不同的模型系列。系列会持续更新,版本间的训练数据、上下文长度和服务方式也可能变化。因此,本节不维护排行榜,而关注较稳定的设计差异。
选型时至少记录四类信息:
- 架构与能力边界:模型如何处理文本、图像、音频和工具调用。
- 训练与适配方式:能否微调,是否提供基础模型和指令模型。
- 交付方式:下载权重自行部署,还是调用托管 API。
- 工程约束:许可证、数据处理方式、延迟、吞吐、显存和费用。
常见设计路线
Decoder-only
Decoder-only 模型根据已有 token 预测后续 token,是当前生成式语言模型的常见架构。GPT、Llama、Qwen 和 Mistral 等系列都包含这类模型。
它适合续写、对话和代码生成,但架构相同不代表能力相同。训练数据、训练方法、上下文处理和对齐方式都会影响结果。
Encoder 或 Encoder-Decoder
Encoder 模型擅长把输入编码成表示,常用于分类、检索和向量化。Encoder-Decoder 模型先编码输入,再生成输出,常用于翻译、摘要等输入到输出任务。
如果任务只需要检索向量或分类结果,使用专用编码模型通常比调用大型生成模型更直接。
稠密模型与混合专家模型
稠密模型在每次前向计算中使用大部分参数。混合专家模型(MoE)用路由器为每个 token 选择部分专家参数。
MoE 可以扩大总参数量而不同比例增加单次计算量,但会引入路由、负载均衡、通信和部署复杂度。“总参数量”与“单次激活参数量”需要分开比较。
多模态模型
多模态模型把图像、音频或视频编码为可与文本共同处理的表示。评估时应拆分任务,例如图像问答、文字识别、目标定位或音频理解,不能用“支持多模态”替代具体测试。
基础模型与指令模型
同一家族常同时提供不同训练阶段的版本:
| 类型 | 主要目标 | 常见用途 | 注意事项 |
|---|---|---|---|
| 基础模型 | 继续预训练式的 token 预测 | 领域继续训练、研究 | 未必能稳定遵循对话指令 |
| 指令模型 | 按指令产生回答 | 对话、应用原型 | 输出风格和安全策略受对齐数据影响 |
| 专用模型 | 针对代码、数学或向量表示等任务训练 | 明确的垂直任务 | 优势是否成立要用本任务数据验证 |
微调前要确认所选版本。将指令模型当作基础模型继续训练,或把基础模型直接用于对话,都可能得到与预期不同的结果。
自部署权重与托管 API
“开放权重”和“托管服务”比“开源”和“闭源”的二分更准确:有些模型允许下载权重,但许可证、训练数据和训练代码并不完全开放。
| 维度 | 自部署权重 | 托管 API |
|---|---|---|
| 数据路径 | 可在自有环境内处理 | 需核对服务商的数据政策 |
| 定制 | 通常可量化、微调和修改模型推理配置 | 取决于服务接口 |
| 运维 | 自行负责硬件、扩缩容和监控 | 服务商承担基础设施运维 |
| 成本 | 与利用率、硬件和运维有关 | 通常按请求量或 token 计费 |
| 更新 | 可固定版本,也需自行升级 | 版本和接口可能由服务商更新 |
| 许可 | 需逐项核对模型许可证 | 需核对服务条款和地区限制 |
二者没有固定优劣。低流量验证阶段,API 往往更省运维;稳定高负载、离线或数据边界严格的场景,才更值得评估自部署。
用任务数据做选择
模型公开基准只能用于筛选候选项,最终选择应在自己的数据和约束下完成。建议保存一份最小评测记录:
任务:要完成什么输入到输出
数据:评测集来源、规模、是否含敏感信息
质量:任务指标 + 人工错误分类
效率:端到端延迟、吞吐、峰值显存
成本:固定负载下的月成本或单次成本
约束:许可证、部署位置、上下文长度、工具支持
版本:模型、模型推理框架、量化方式和提示词版本
不要只看平均分。还应检查模型在哪些样本上失败,以及错误是否可以通过检索、工具调用、微调或业务规则修正。
代码实验
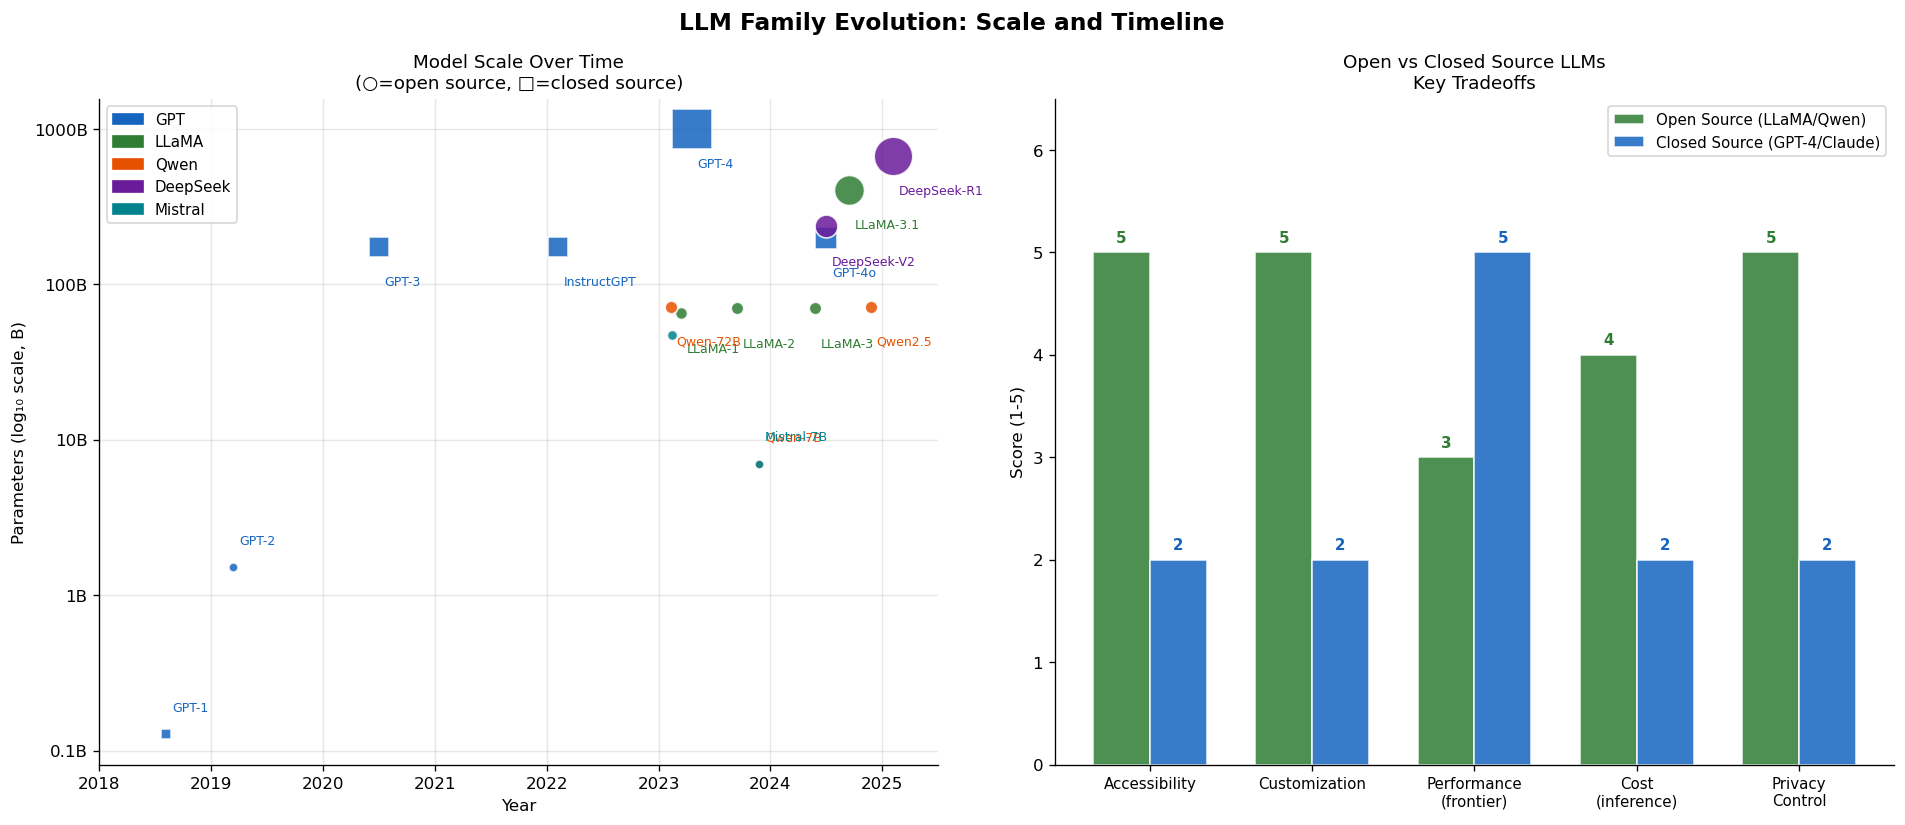
图5.3:示例模型系列的发布时间与参数规模。该图用于练习整理模型元数据,不表示能力排名。
代码文件: code/ch05_llm_basics/model_families_evolution.py
运行方式: python code/ch05_llm_basics/model_families_evolution.py
运行后检查图中的来源、版本和参数口径。模型信息会变化,不应把脚本内数据直接当作当前选型结论。
本节小结
- 用架构、适配方式、交付方式和工程约束描述模型,而不是背版本排名。
- 区分基础模型、指令模型和专用模型,也区分总参数量与激活参数量。
- 用自己的任务数据同时评估质量、错误类型、延迟、成本和许可条件。
下一节: 5.4 微调