
7.1 视觉-语言对齐
核心问题: 如何让模型理解图像和文本的关系?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
问题
图像和文本是两种不同的模态,如何在同一个模型中处理?
挑战:
- 图像是像素矩阵
- 文本是离散的单词
- 需要找到共同的表示空间
核心组件速览
在深入之前,先理解多模态 LLM 的三个关键组件及其角色。这里的重点是组件职责,不是固定模型列表:
| 组件 | 输入 | 输出 | 角色 | 代表模型 |
|---|---|---|---|---|
| ViT | 图像 | 图像特征向量 | 视觉编码器 | LLaVA、Qwen2.5-VL |
| CLIP | 图像+文本 | 联合嵌入空间 | 图文对齐(桥梁) | 零样本分类、检索 |
| LLM | 文本+视觉特征 | 文本响应 | 语言理解与生成 | 多模态助手 |
关键区别:
- ViT:单向(图像→特征),用于特征提取
- CLIP:双向(图像+文本→对齐),用于对齐
- LLM:多模态理解,用于推理能力和生成
多模态架构的演进
早期方法:特征拼接
思想: 分别提取图像和文本特征,然后拼接。
图像 → CNN → 特征1
文本 → RNN → 特征2
      ↓
    拼接 → 分类器
问题:
- 特征空间不对齐
- 跨模态信息利用不足
对比学习方法:CLIP
思想: 用对比学习对齐图像和文本特征。
单向损失: 对 batch 中归一化后的图像表示
实际通常再计算文本到图像方向并取平均。
优势:
- 特征空间对齐
- 零样本学习能力强
融合方法:LLaVA
思想: 用投影层连接视觉编码器和LLM。
图像 → ViT → 投影层 → LLM → 输出
                ↑
              文本
关键组件:
- 视觉编码器:提取图像特征
- 投影层:对齐特征空间
- LLM:理解和生成文本
视觉编码器详解
步骤1:提取图像特征
用CNN或Vision Transformer(ViT)提取图像特征。
图像(3×H×W)
  ↓
ViT或CNN
  ↓
图像特征(N×D)
Vision Transformer(ViT)
基本思想: 把图像分成小块(patches),用Transformer处理。
图像
  ↓
分成16×16的patches
  ↓
线性投影
  ↓
Transformer
  ↓
图像特征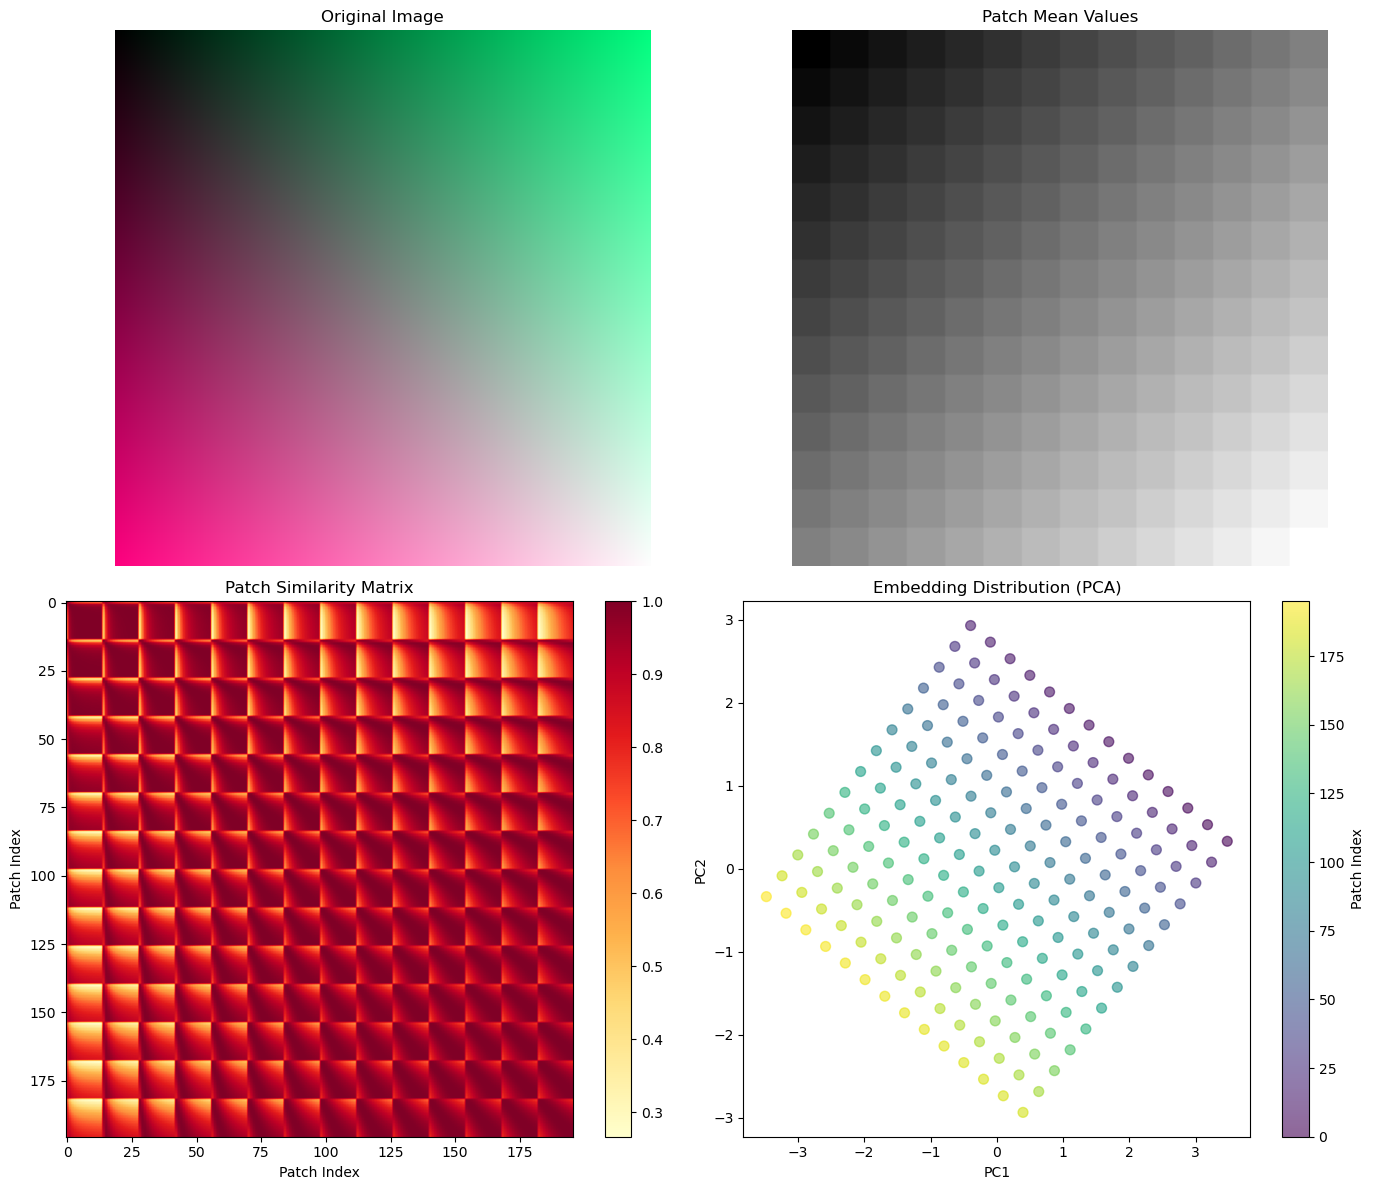
图7.1a:Vision Transformer 图像分块可视化——原始图像分割成 16×16 的 patches,每个 patch 线性展开后加位置编码送入 Transformer。
代码文件: code/ch07_multimodal_llm/vit_patches.py
运行方式: python code/ch07_multimodal_llm/vit_patches.py
ViT的详细步骤
分块:把图像分成
的patches - 图像大小:
- Patch大小:
- Patch数量:
- 图像大小:
线性投影:把每个patch投影到向量
- 输入:
的patch - 输出:
维向量
- 输入:
位置编码:添加位置信息
- 类似NLP中的位置编码
- 让模型知道patch的位置
Transformer:处理patch序列
- 自注意力:学习patch之间的关系
- 前馈网络:非线性变换
ViT的优势
- 可扩展性:可以扩展到不同分辨率的图像,但会受到 visual token 数和位置编码设计的限制
- 全局建模:自注意力可以直接建模 patch 之间的长距离关系
- 统一架构:与NLP中的Transformer一致
计算复杂度
自注意力复杂度:
对于大图像:
- 图像大小:
- Patch大小:
- Patch数量:
- 复杂度:
优化方法:
- 分层ViT:多尺度处理
- 局部注意力:只关注附近的patch
- 稀疏注意力:减少计算量
文本编码器
用标准的Transformer编码文本。
文本
  ↓
Tokenization
  ↓
Embedding
  ↓
Transformer
  ↓
文本特征
对比学习的原理深度
对比学习的几何直观
核心思想: 在高维特征空间中,相似的样本应该聚集在一起,不相似的样本应该分散开来。
几何解释:
特征空间(高维)

相似对(应该接近):
  图像1 ●
        ╲
         ╲ 小距离
          ╲
           ● 文本1

不相似对(应该远离):
  图像1 ●
        ╲
         ╲ 大距离
          ╲
           ● 文本2(不匹配)
为什么这样有效:
- 相似对接近 → 模型学会识别匹配的图像-文本对
- 不相似对远离 → 模型学会区分不匹配的对
- 自动形成对齐的特征空间 → 不需要显式的对齐标签
与其他方法的对比:
| 方法 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| MSE损失 | 最小化预测误差 | 简单 | 不能处理多模态 |
| 对比学习 | 相似对接近,不相似对远离 | 自动对齐,零样本能力强 | 需要大批大小 |
| 三元损失 | 相似对比不相似对更接近 | 直观 | 需要手工选择负样本 |
为什么对比学习能对齐特征?
关键机制: 通过最大化相似对的相似度、最小化不相似对的相似度,自动学习对齐。
数学直观:
给定一个图像-文本对
- 目标:
应该大(相似对接近) - 约束:
应该小,其中 是不匹配的文本
为什么这能创建共同的表示空间:
- 相似对的拉力: 模型被迫让匹配的图像和文本特征接近
- 不相似对的推力: 模型被迫让不匹配的对分散
- 自动对齐: 这两个力共同作用,自动创建对齐的特征空间
与显式对齐的区别:
- 显式对齐:需要手工标注对应关系
- 对比学习:从数据中自动学习对应关系
对齐质量与下游任务的关系
对齐质量的度量:
相似度分布: 相似对的相似度应该高,不相似对应该低
好的对齐:
相似对相似度:0.8-0.95
不相似对相似度:0.1-0.3

差的对齐:
相似对相似度:0.5-0.6
不相似对相似度:0.4-0.5
检索准确率: 给定图像,能否正确检索对应的文本
- 好的对齐:Top-1准确率 > 90%
- 差的对齐:Top-1准确率 < 50%
对齐与零样本学习的关系:
零样本分类的原理:
1. 给定图像和类别文本描述
2. 计算图像与每个类别的相似度
3. 选择相似度最高的类别

这只有在特征空间对齐时才能工作!
对齐与下游任务的关系:
| 任务 | 对齐的重要性 | 原因 |
|---|---|---|
| 零样本分类 | 🔴 极高 | 主要依赖相似度排序 |
| 图像检索 | 🔴 极高 | 需要准确的相似度排序 |
| VQA | 🟠 中等 | 需要理解图像内容 |
| 图像描述 | 🟠 中等 | 需要理解图像内容 |
常见失败模式:
- 图像文字太小或模糊,视觉编码器无法提取细节
- 图文描述存在歧义,对比学习可能学到粗粒度相关而不是精确对应
- 空间关系、计数和细粒度属性比普通图文检索更难
- 下游任务要求的证据粒度高于预训练对齐数据提供的粒度
ViT vs CNN:为什么Transformer常用于图文对齐?
CNN的特点: 局部卷积从小感受野开始,依靠多层堆叠、池化或大卷积核逐步扩大感受野。它可以建模整体语义,但全局关系通常不是第一层就直接可见。
ViT的优势: 自注意力机制让每个 patch 可以直接关注其他 patch,更容易形成全局图像表示;这与文本描述通常表达全局语义的方式更接近,因此常用于图文对齐模型。
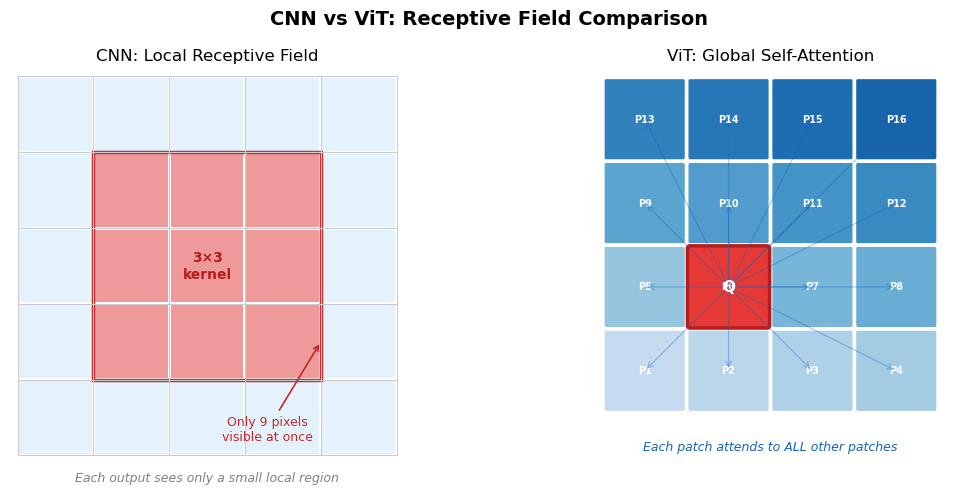
图7.1c:CNN 局部感受野(每次只看 3×3 区域)vs ViT 全局自注意力(每个 patch 关注所有其他 patch)的直观对比。
代码文件: code/ch07_multimodal_llm/architecture_diagrams.py运行方式: python code/ch07_multimodal_llm/architecture_diagrams.py
为什么全局感受野对对齐更重要:
- 上下文范围: “一个人在公园里”需要联合人、场景和关系,模型必须形成足够大的有效感受野。
- 归纳偏置: CNN 从局部连接与平移结构出发,ViT 用 patch 和自注意力直接建立长距离关系;两者经过堆叠后都可以形成全局表示。
- 对齐粒度: 全局图文检索可以使用单个向量,定位、OCR 和细粒度问答通常还需要 patch 或区域级表示。文本也可能描述局部区域,不能默认“文本天然全局”。
温度参数的作用与边界
温度缩放 logits:较小的
不同τ值的效果:
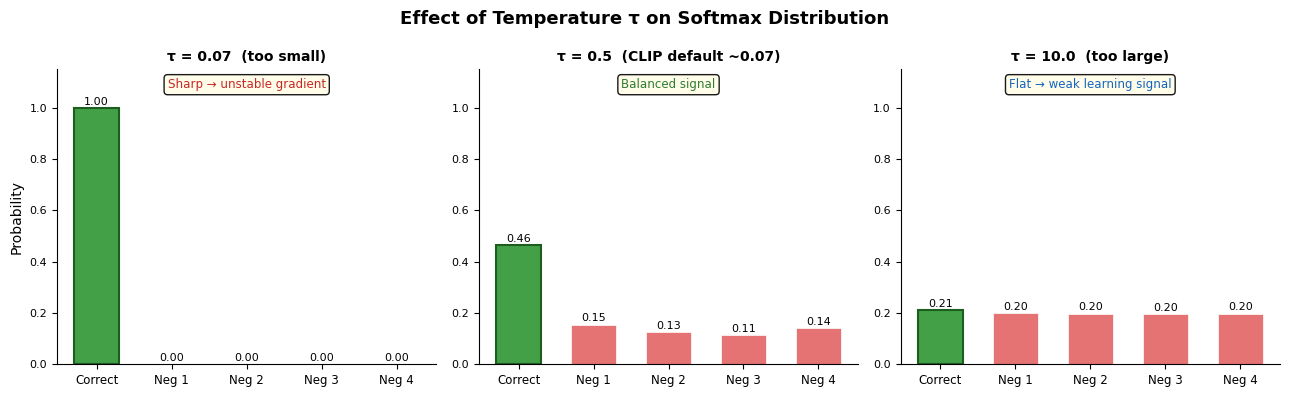
图7.1d:固定同一组 logits 时,三种温度对应的 softmax 分布。该图只展示缩放效果,不表示某个温度在所有训练任务中最优。
代码文件: code/ch07_multimodal_llm/architecture_diagrams.py运行方式: python code/ch07_multimodal_llm/architecture_diagrams.py
不能仅凭
- 温度过小时,少数高分负例可能主导损失,错误配对和假负例的影响也会被放大;
- 温度过大时,不同配对的概率差异被压缩,对齐信号可能变弱;
- 固定经验值不具有跨模型通用性,一些实现直接学习 logit scale;
- 选择温度时应同时观察验证集检索指标、损失、梯度范数和训练稳定性,并记录最终温度或缩放值。
对齐:对比学习的数学基础
对齐的目标
让匹配图文在共同表示空间中的相似度高于 batch 内不匹配组合。这里学习的是相对排序关系,不保证每个未配对样本都在语义上真正无关。
损失函数
本节开头给出了
归一化表示的点积等于余弦相似度。完整符号和适用边界见附录 A.9。
批大小的影响
较大的 batch 提供更多批内负例,也增加显存和跨设备通信;如果数据中存在重复图像、近义文本或错误配对,假负例也会随之增加。因此 batch size 不是越大越好,比较实验时还要固定有效 batch、采样方式和温度设置。
代码实验
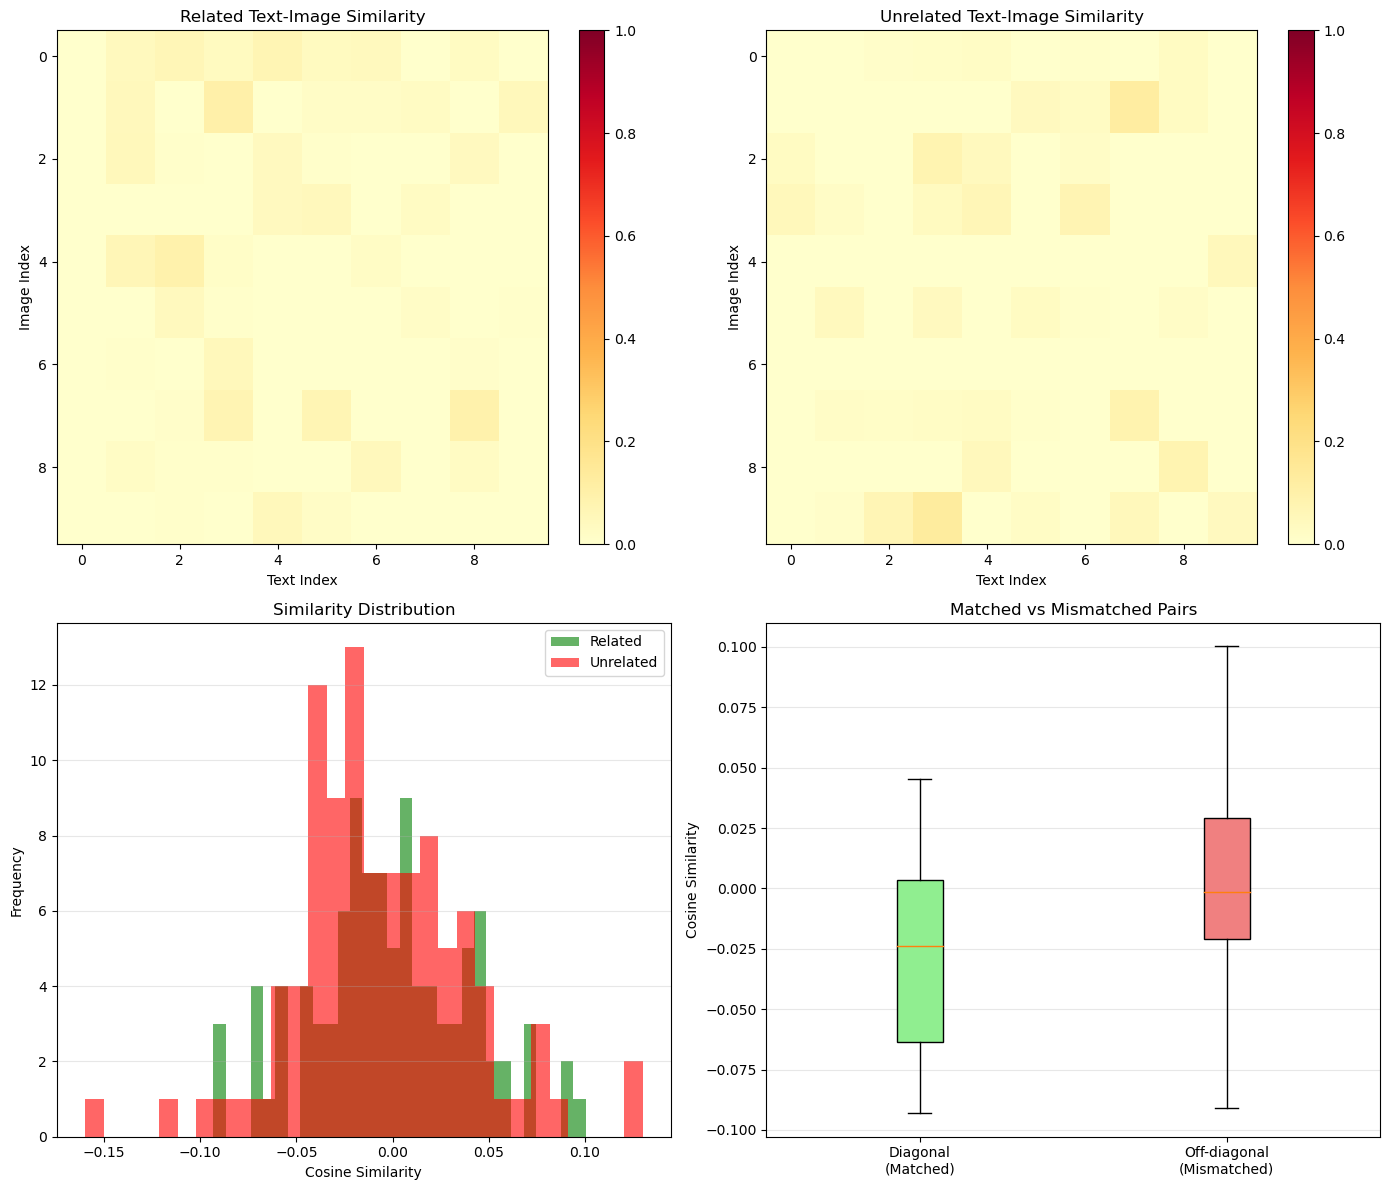
图7.1b:CLIP 图像-文本相似度矩阵——对角线最亮表示对比学习对齐效果好,相似对相似度高,不相似对相似度低。
代码文件: code/ch07_multimodal_llm/clip_similarity.py
运行方式: python code/ch07_multimodal_llm/clip_similarity.py
本节小结
视觉-语言对齐经历了从特征拼接到对比学习再到融合方法的演进。核心思想是:
- 用ViT提取图像特征
- 用Transformer提取文本特征
- 用对比学习对齐两个特征空间
下一节: 7.2 从非视觉信号到语言对齐
扩展阅读: 对比学习与投影层深度细节(InfoNCE 推导、温度参数原理、投影层设计)