
5.5 偏好对齐:SFT、RLHF 与 DPO
核心问题: 如何用示范与偏好数据调整模型行为?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
预训练目标与应用目标不同
预训练通常最小化下一个 token 的预测损失。这个目标不会直接规定回答格式、拒答边界或业务规则。要把基础模型用于对话,还需要示范数据、偏好数据和运行时约束。
这些方法主要调整模型的输出分布,不保证事实正确,也不能替代安全测试。
SFT:从示范中学习
监督微调(Supervised Fine-Tuning,SFT)使用“指令—回答”样本继续训练模型:
[指令] 用一句话解释什么是黑洞。
[回答] 黑洞是引力强到连光也难以逃逸的天体区域。
SFT 可以训练对话格式、任务步骤、输出结构和部分拒答行为。它的边界由数据覆盖决定:示范不足、标签冲突或分布偏移都会影响结果。
本节与第 6 章的任务微调使用相同的监督学习机制,区别主要在数据和目标:通用 SFT 覆盖多类指令,任务微调聚焦特定输入、输出和评价标准。
奖励模型:拟合偏好比较
偏好数据通常包含同一提示下的两个回答及其排序:
(prompt, chosen_response, rejected_response)奖励模型为“提示—回答”输出标量分数,并训练为让偏好回答得分更高。常见成对损失可写为:
其中
这个分数是标注偏好的近似,不是“有用”或“安全”的客观测量。标注规范、标注者差异和奖励模型的泛化误差都会影响后续训练。
RLHF:用奖励更新策略
基于人类反馈的强化学习(RLHF)通常包含:
预训练模型
  → SFT
  → 收集回答偏好并训练奖励模型
  → 用奖励模型更新语言模型策略
对一个提示生成回答后,奖励模型提供训练信号。策略优化常加入相对参考模型的 KL 惩罚:
KL 项限制策略偏离参考模型的幅度。它有助于控制更新,但不能阻止所有奖励投机或不安全输出。
PPO 是可用于策略更新的方法之一。实际训练还需要处理采样成本、奖励尺度、价值估计和训练稳定性,因此系统复杂度高于普通 SFT。
DPO:直接使用偏好对
直接偏好优化(Direct Preference Optimization,DPO)在特定奖励建模假设下,把带 KL 正则的偏好优化改写为分类式目标。训练直接比较偏好回答与非偏好回答相对参考模型的对数概率,无需单独训练奖励模型和运行在线强化学习循环。
RLHF:偏好数据 → 奖励模型 → 策略优化
DPO: 偏好数据 + 参考模型 → 策略优化| 方面 | 基于奖励模型的 RLHF | DPO |
|---|---|---|
| 偏好信号 | 先拟合奖励模型 | 直接使用偏好对 |
| 训练流程 | 包含生成采样和策略优化 | 接近监督训练流程 |
| 可扩展性 | 奖励模型可用于新回答打分 | 依赖已有成对样本 |
| 主要风险 | 奖励模型误差、奖励投机、训练不稳定 | 偏好数据偏差、参考模型选择、分布外泛化 |
DPO 流程较短,但不意味着质量一定优于 RLHF。二者都需要独立评测,而不是只比较训练损失。
如何评估对齐训练
至少分开检查以下指标:
- 任务完成:格式正确率、指令约束满足率和任务指标。
- 偏好一致性:盲评胜率及其置信区间。
- 事实性:可验证问题上的引用、答案与不确定性表达。
- 安全性:明确的风险分类、攻击集和误拒率。
- 能力保持:对齐前后的通用与领域评测差异。
“有用、无害、诚实”可以作为目标分类,但必须转换成数据集、标注规则和指标,才能用于验收。
代码实验
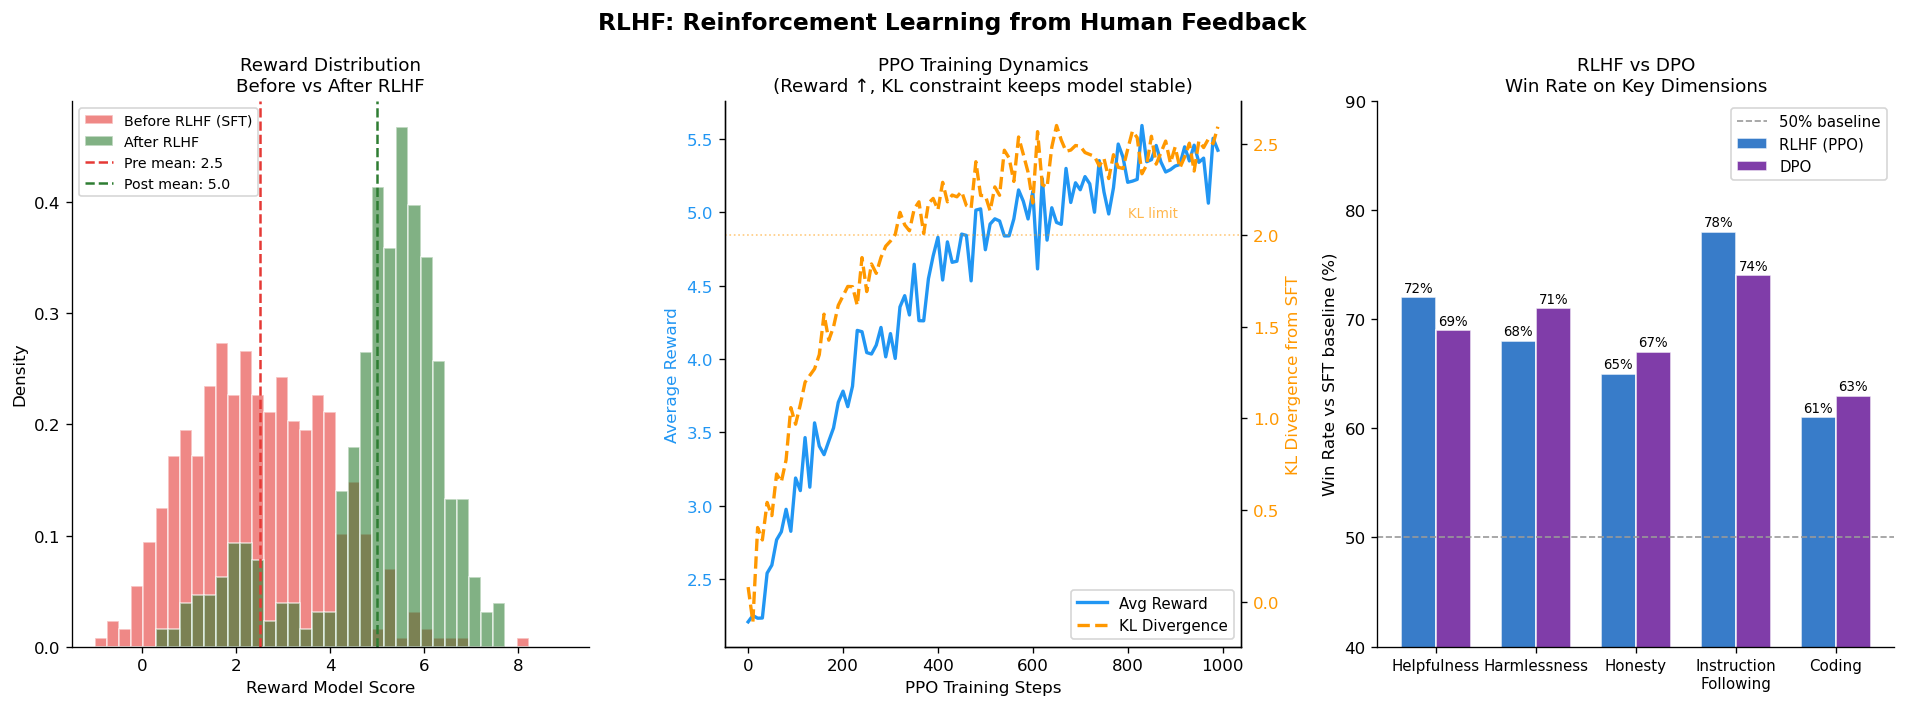
图5.5:SFT、奖励模型、策略优化与 DPO 的数据流。箭头表示训练依赖,不表示质量保证。
代码文件: code/ch05_llm_basics/rlhf_pipeline.py
运行方式: python code/ch05_llm_basics/rlhf_pipeline.py
本节小结
- SFT 用示范数据训练输出行为。
- 奖励模型拟合偏好排序,分数会继承数据和模型误差。
- RLHF 用奖励更新策略,并常用 KL 项限制偏移。
- DPO 直接使用偏好对,流程更短,但仍需评估数据偏差与能力退化。