
5.6 模型评估
核心问题: 如何判断一个 LLM 是否"好"?评估为什么比想象中难?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
为什么评估 LLM 很难
固定标签的分类或回归任务通常有明确目标,可以从准确率、误差等指标开始;但仍要检查数据切分、类别不平衡和分布漂移。开放式生成进一步增加了答案不唯一和评价维度冲突的问题。
LLM 的评估难在:
问题:写一首关于秋天的诗
回答A:秋风萧瑟,落叶纷飞,天高云淡,雁南飞。
回答B:秋天来了,树叶变黄了,天气变冷了。

哪个更好?为什么?怎么量化?
核心困难:
- 开放式生成没有唯一正确答案
- 质量是多维度的(准确、有用、安全、流畅)
- 人类评估成本高且主观
- 自动指标和人类判断经常不一致
自动评估指标
Perplexity(困惑度)
定义: 模型对测试 token 序列平均负对数似然的指数化结果;在相同计分口径下越低,表示模型给这些 token 的平均概率越高。
直觉: PPL 可以粗略理解为模型面对的“有效候选分支数”,但它不是模型实际枚举候选数量的计数。
局限: 它只衡量指定文本上的语言建模能力,不衡量有用性、事实准确性或安全性。只有 tokenizer、数据集、预处理和对数口径一致时,PPL 才适合直接比较。公式约定见附录 A.8。
基准测试(Benchmark)
不同基准只覆盖能力空间的一部分。表中的名称用于说明评测类型,不代表固定推荐名单;使用时应锁定数据集版本、评分脚本和提示模板。
| 评测方向 | 示例 | 常见计分方式 | 主要风险 |
|---|---|---|---|
| 学科知识 | MMLU、C-Eval、CMMLU | 多选准确率 | 训练数据污染、题目格式敏感 |
| 常识与科学问答 | HellaSwag、ARC | 选择或补全准确率 | 选项顺序、提示模板影响 |
| 数学解题 | GSM8K、MATH | 最终答案或步骤匹配 | 答案抽取、过程正确但格式不同 |
| 代码生成 | HumanEval、MBPP | 单元测试通过率 | 测试覆盖不足、运行环境差异 |
| 指令遵循 | IFEval | 规则检查 | 只覆盖可形式化约束 |
| 开放式对话 | MT-Bench、AlpacaEval | 模型裁判或成对比较 | 裁判偏差、长度和文风偏好 |
| 事实性与安全 | TruthfulQA、领域测试集 | 规则、分类器或人工复核 | 任务定义与真实风险不一致 |
人工评估
自动 Benchmark 有局限,人工评估更接近真实使用体验。
偏好标注
给标注者两个模型的回答,让他们选择更好的那个:
问题:如何学习编程?

模型A的回答:建议从 Python 开始,先学基础语法...
模型B的回答:编程学习需要循序渐进,首先...

标注者选择:□ A 更好  □ B 更好  □ 差不多
优点: 直接反映人类偏好,不受 Benchmark 格式限制。
缺点: 成本高,标注者之间一致性差,难以规模化。
在线匿名成对评测
用户在不知道模型身份时比较两个回答并投票,平台再聚合成相对排名。具体平台、模型池和统计方法会变化,因此报告结果时应记录日期、样本量和置信区间。
用户提问 → 两个匿名模型各自回答 → 用户投票 → 聚合相对排名优点: 能覆盖实验室数据集之外的真实问题和主观偏好。 缺点: 用户群体、模型抽样、展示顺序和文风偏好都会影响结果,偏好也不等于事实正确。
LLM-as-Judge
使用另一个模型按 rubric 对候选输出打分、分类或成对比较。裁判模型不必然比被评模型可靠,因此需要用人工标注集校准。
评估 prompt:
  问题:{question}
  模型回答:{answer}
  请从准确性、有用性、安全性三个维度打分(1-10),并说明理由。
优点: 适合快速、重复地覆盖大量样本,并能输出分项理由。 缺点: 会受到裁判版本、提示模板、位置偏差、长度偏好和同源模型偏好的影响。应锁定裁判版本,随机交换候选顺序,并抽样人工复核。
指标被优化后的失真
当团队长期针对一个公开指标调优时,指标与真实目标之间的相关性可能下降。
Benchmark 刷分问题:
现象:
  模型在 MMLU 上得分 90%
  但实际使用中表现平平

原因:
  训练数据中包含了 MMLU 的题目(数据污染)
  或者针对 MMLU 格式专门优化(过拟合)
常见原因包括训练数据污染、针对固定格式调优,以及评分脚本没有覆盖关键失败模式。
应对方法:
- 使用多个 Benchmark,避免单一指标
- 定期更新 Benchmark,减少数据污染
- 结合规则、模型裁判、人工评估和线上反馈
- 关注模型在新问题上的表现,而非已知题目
评估维度总结
一个完整的 LLM 评估应该覆盖多个维度:
| 维度 | 评估方法 | 代表 Benchmark |
|---|---|---|
| 知识广度 | 多选题 | MMLU、C-Eval |
| 数学推理 | 解题 | GSM8K、MATH |
| 代码能力 | 生成+执行 | HumanEval、MBPP |
| 指令遵循 | 规则检查 | IFEval |
| 对话质量 | LLM 打分 | MT-Bench |
| 真实偏好 | 匿名成对投票 | 在线对比平台或自建用户实验 |
| 安全性 | 红队测试 | TruthfulQA、专项测试 |
代码实验
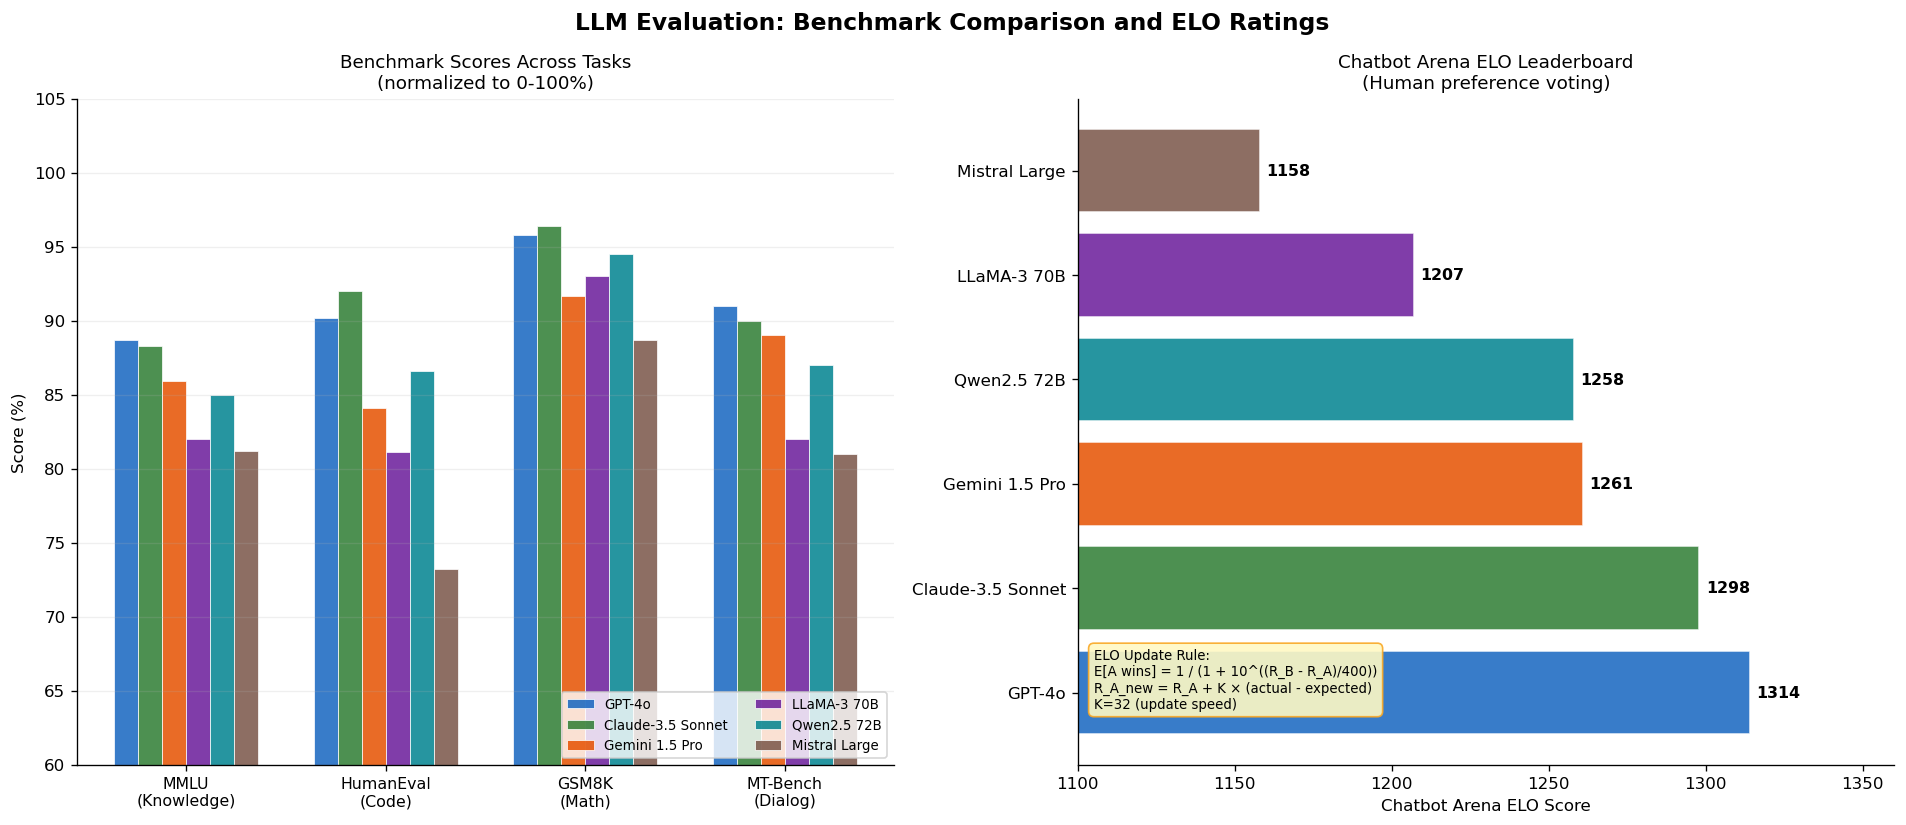
图5.6a:LLM 评估基准对比——MMLU、HumanEval、MT-Bench 等主流基准的覆盖维度与适用场景。
代码文件: code/ch05_llm_basics/benchmark_comparison.py
运行方式: python code/ch05_llm_basics/benchmark_comparison.py
本节小结
- 开放式生成没有唯一答案,需要把事实性、任务完成度、安全性和表达质量拆开评价
- 自动基准高效但受数据污染、提示模板和评分脚本影响
- 人工评估更接近目标用户判断,但必须记录 rubric、标注者和一致性
- LLM-as-Judge 适合规模化初筛,不能替代人工校准与失败样本复核
- 评估应组合语言建模指标、任务指标、分组错误、资源指标和真实场景验收
扩展阅读: E5.x 评估方法调研
下一章: 第6章:LLM应用