
2.7 决策树与随机森林
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
核心概念
决策树通过递归分割特征空间来做预测;随机森林通过集成多棵树来降低过拟合。
📚 深入学习: 对树数据结构的实现细节感兴趣?请参考 扩展:树数据结构基础,其中包含树的遍历、递归实现、剪枝等内容。
决策树(Decision Tree)
思想: 通过一系列的"是/否"问题递归地分割数据,直到每个区域内的数据足够纯净。
构建过程:
- 选择最佳分割特征和阈值
- 将数据分为左右两个子集
- 递归地对子集进行分割
- 直到达到停止条件(最大深度、最小样本数等)
分割标准:基尼系数(Gini Index)
其中
- 纯节点(只有一个类别):Gini = 0
- 混合节点(多个类别):Gini > 0
最佳分割: 选择使加权Gini最小的分割
随机森林(Random Forest)
思想: 通过 Bootstrap 采样和特征随机性,训练多个决策树,再用投票或平均完成预测。
构建过程:
- 对原始数据进行Bootstrap采样(有放回地随机抽样)
- 对每个Bootstrap样本训练一个决策树
- 在每个节点,随机选择特征子集进行分割
- 重复
次(通常 或更多)
预测:
- 分类:多数投票
- 回归:平均值
决策树 vs 随机森林
| 方面 | 决策树 | 随机森林 |
|---|---|---|
| 模型 | 单个树 | 多个树的集合 |
| 过拟合 | 容易过拟合 | 通过集成降低过拟合 |
| 可解释性 | 高(可视化) | 低(难以解释) |
| 计算复杂度 | 低 | 中等 |
| 泛化能力 | 一般 | 较好 |
| 特征重要性 | 可计算 | 可计算 |
集成学习的思想
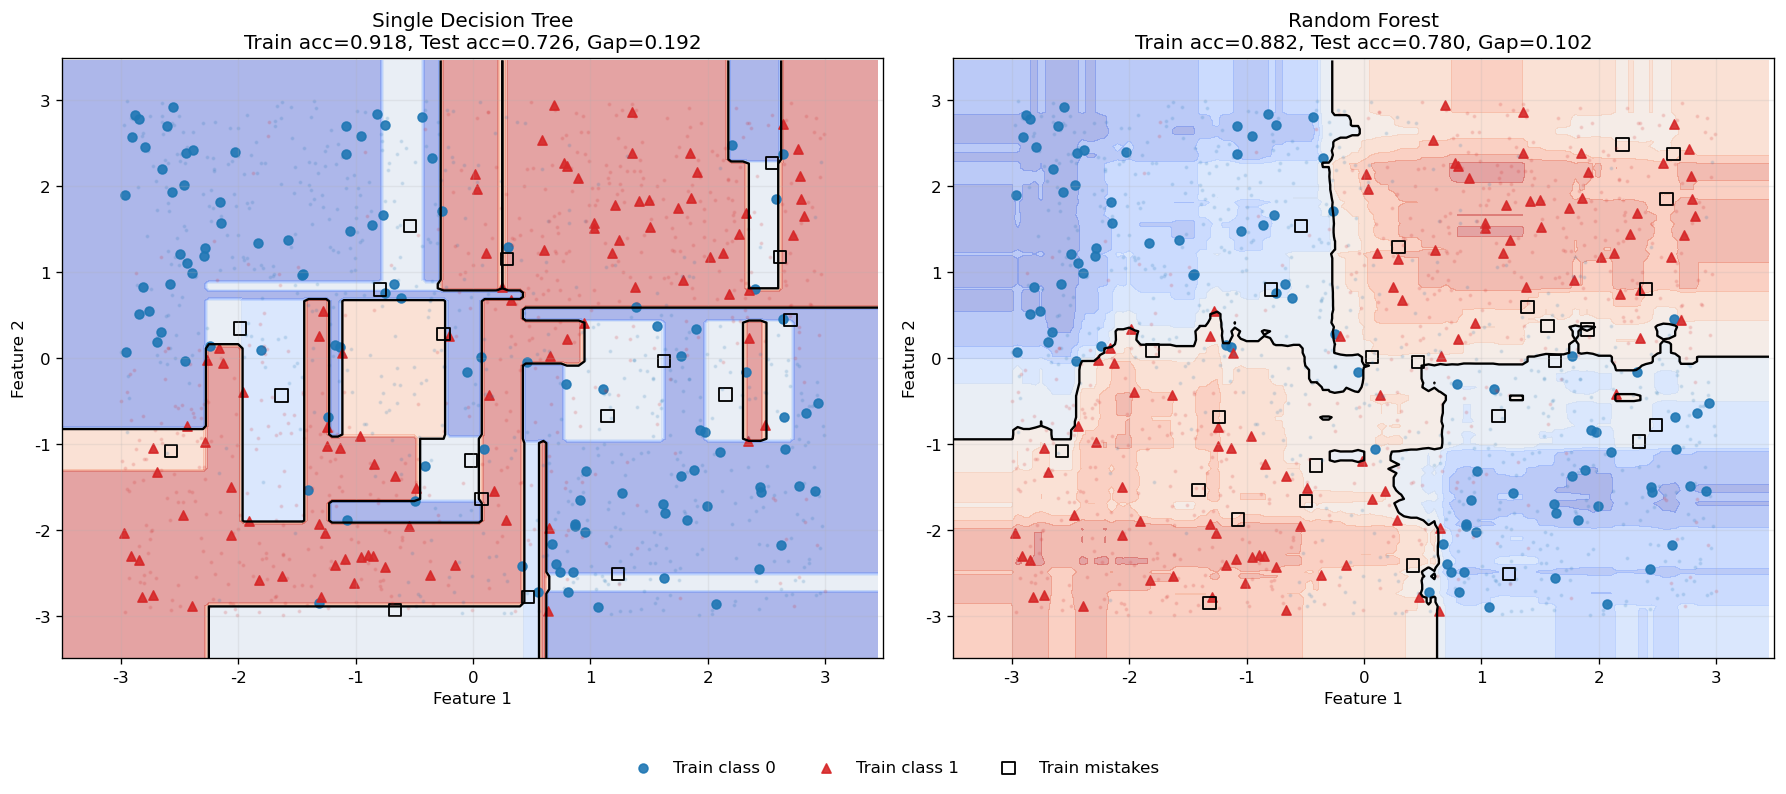
随机森林通过 Bootstrap 采样和随机选择候选特征,使各棵树产生差异。对预测取平均或投票,通常可以降低单棵深树的方差。树之间仍可能相关,随机化只能降低相关性,不能保证独立。
数学解释: 在一个简化分析中,假设每棵树的错误率均为
当
代码实验
完整的代码示例位于:code/ch02_optimization/decision_tree_random_forest.py
运行方式:
python code/ch02_optimization/decision_tree_random_forest.py代码包含:
- 决策树的实现
- 随机森林的实现
- 决策边界可视化
- 集成效果对比
 代码文件:
code/ch02_optimization/decision_tree_random_forest.py
运行方式: python code/ch02_optimization/decision_tree_random_forest.py
图2.7:单棵决策树与随机森林在同一带噪非线性分类任务上的决策边界对比。标题同时给出训练准确率、测试准确率和泛化间隙:单树更容易把训练集切得很碎,从而获得更高训练分数但更大的泛化损失;随机森林通过多棵树的平均让边界更平滑,测试表现也更稳定。
与神经网络的边界
决策树和神经网络都能用于分类或回归,但训练机制不同:
| 决策树 / 随机森林 | 神经网络 |
|---|---|
| 递归选择特征和阈值 | 通过反向传播联合更新参数 |
| 形成分段、轴对齐的区域 | 学习连续的多层表示 |
| 适合表格特征,也能给出分裂规则 | 常用于图像、音频和文本等高维输入 |
多头注意力不是随机森林。注意力头是同一网络中共同训练的表示通道;随机森林中的树以随机样本和特征训练,再对最终预测投票或平均。二者都出现“多路结果”,不足以说明机制相同。
实际项目中,可以把树模型作为表格任务的基线,再根据数据类型、指标和部署约束判断是否需要神经网络。
本节小结
- 决策树用特征和阈值递归划分样本空间。
- 随机森林通过树之间的差异和预测聚合降低方差,但不能保证一定优于单树。
- 树模型与 Transformer 的训练机制不同,不需要用随机森林解释多头注意力。
下一章: 阅读 第3章:深度学习快速入门