
2.2 动量与自适应优化器
核心问题: 如何利用历史梯度调整更新方向和每个参数的步长?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
Momentum
Momentum 对历史梯度做指数加权:
它可以平滑小批量梯度噪声,并在方向持续一致时累积更新。
RMSprop
RMSprop 维护平方梯度的移动平均:
平方和开方均按元素计算。近期梯度尺度较大的参数会得到较小的有效步长。
Adam 与 AdamW
Adam 同时估计一阶矩和二阶矩:
初始化为零会让早期估计偏小,因此使用偏差修正:
AdamW 将权重衰减作为独立更新项,而不是把 L2 项直接混入自适应梯度。它是 Transformer 训练中的常见起点,但学习率、权重衰减、
选择依据
| 方法 | 使用历史方向 | 按参数调整尺度 | 额外状态 |
|---|---|---|---|
| SGD | 否 | 否 | 无 |
| Momentum | 是 | 否 | 1 份 |
| RMSprop | 否 | 是 | 1 份 |
| Adam / AdamW | 是 | 是 | 2 份 |
自适应优化器增加优化器状态显存,也不保证所有任务上泛化更好。比较时应固定数据、初始化、训练预算和调度策略。
代码实验
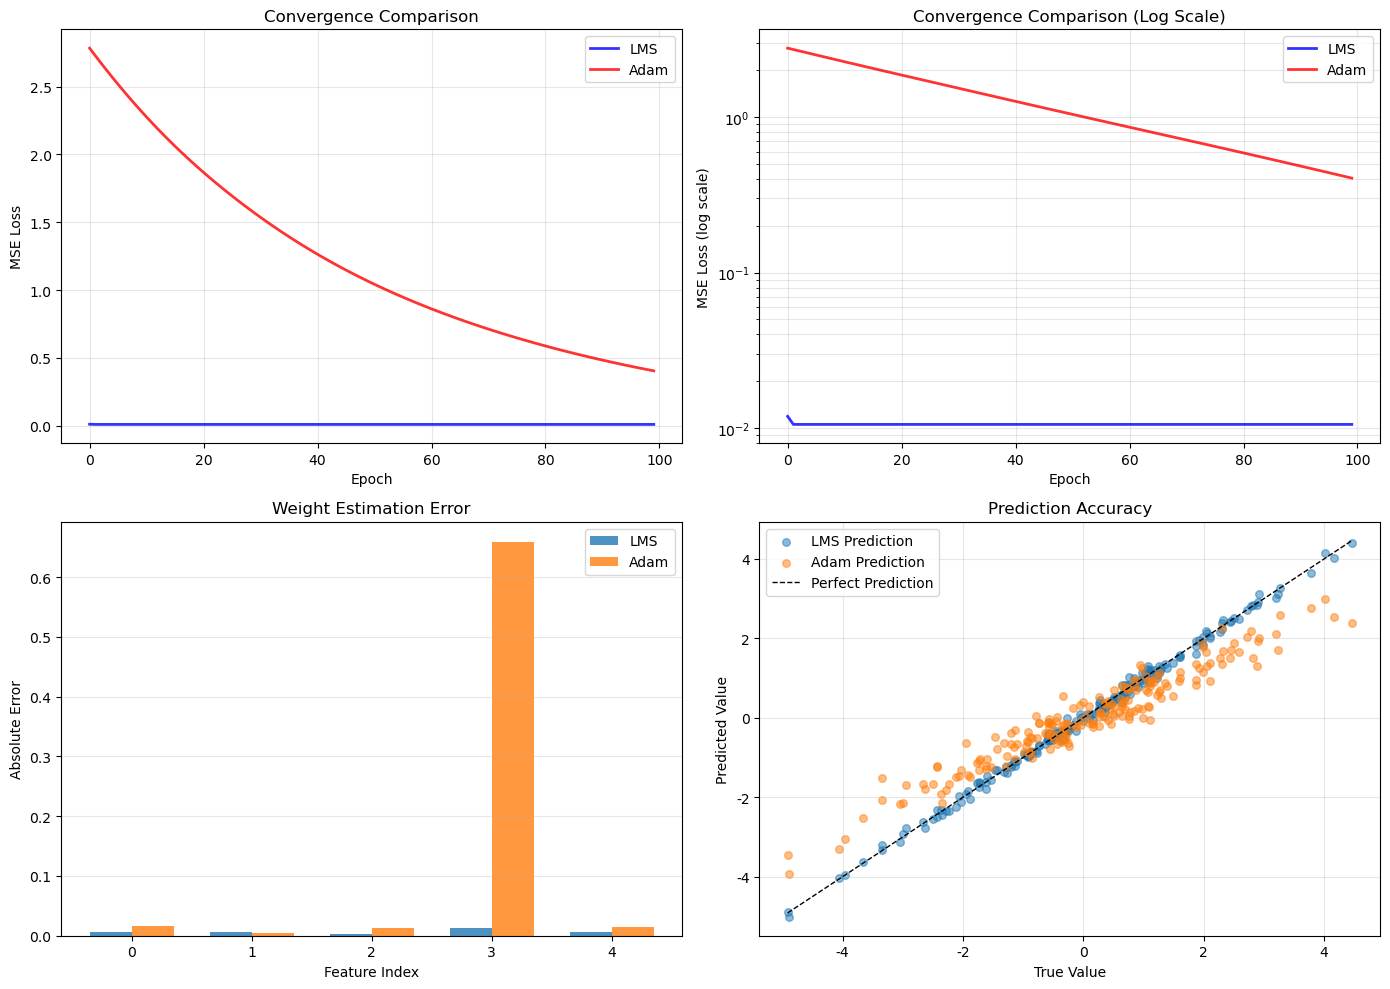
图2.2:LMS 与 Adam 在一个参数估计任务上的收敛和误差。
代码文件: code/ch02_optimization/lms_vs_adam.py
bash
python code/ch02_optimization/lms_vs_adam.py至少比较两组学习率,并同时记录最终测试误差。若 Adam 更快下降,也要检查是否使用了相同更新次数和停止条件。
本节小结
- Momentum 平滑并累积历史方向;RMSprop 按近期梯度尺度调整步长。
- Adam 组合一阶矩与二阶矩,AdamW 另行处理权重衰减。
- 优化器是实验变量,不应仅凭默认参数或训练损失选定。
下一节: 2.3 优化器与模型的分工