
2.6 支持向量机与核方法
核心问题: 如何用间隔和核函数构造分类边界?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
线性 SVM
线性支持向量机寻找决策边界
核方法
核函数计算某个特征空间中的内积:
算法只计算
| 核函数 | 公式 | 主要参数 |
|---|---|---|
| 线性核 | ||
| 多项式核 | 次数 | |
| RBF 核 | 宽度 |
使用核函数后,预测可写为:
只有支持向量对应的系数通常非零。核技巧避免显式展开高维特征,但训练和预测仍可能随样本数增加而变慢。
线性核还是 RBF 核
| 情况 | 可先尝试 |
|---|---|
| 高维稀疏特征或近似线性边界 | 线性 SVM |
| 中小规模、边界明显非线性 | RBF 核 SVM |
| 样本很多、需低延迟预测 | 线性模型或其他可扩展基线 |
特征缩放会影响距离和间隔,应把标准化放进训练管线,并只用训练数据拟合缩放参数。
与神经网络的边界
核 SVM 使用预先选择的核定义相似度;神经网络通过训练学习多层特征变换。二者都能形成非线性决策边界,但参数化方式、优化方法和计算成本不同。
点积注意力也会计算向量相似度,但 Query、Key 和 Value 来自可学习投影,并在序列内动态计算。它不是 RBF 核 SVM 的延伸,不需要用核函数类型去对应不同注意力头。
代码实验
实验在同一数据上比较线性 SVM 与 RBF 核 SVM 的决策边界。
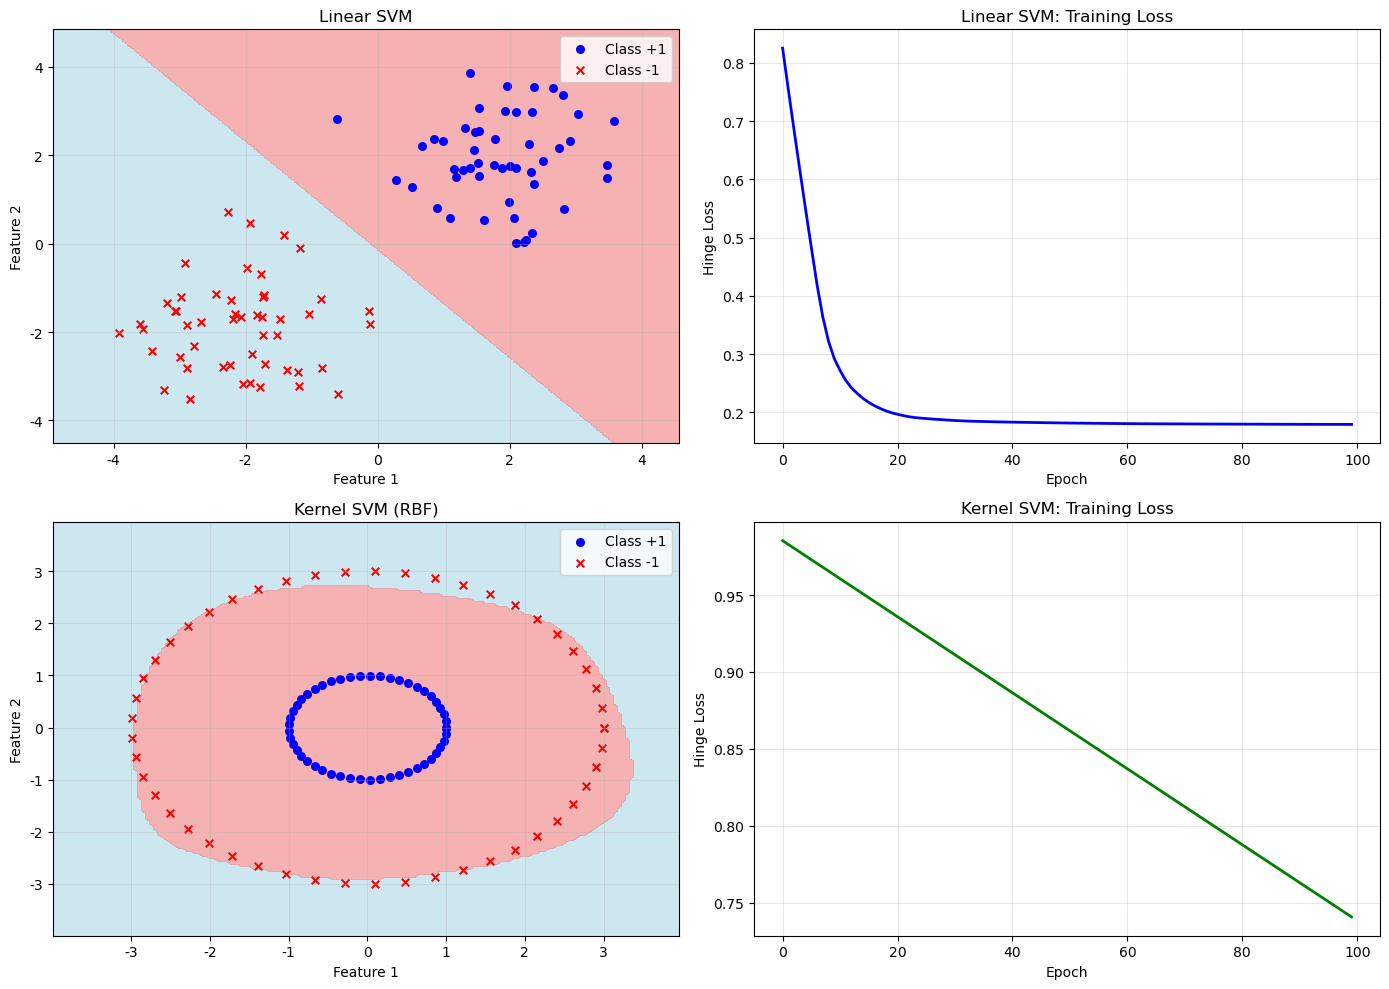
图2.6:线性核与 RBF 核产生的决策边界。图中结果只对应当前数据和超参数。
代码文件: code/ch02_optimization/svm_kernel.py运行方式: python code/ch02_optimization/svm_kernel.py
运行后分别改变
本节小结
- SVM 用间隔和损失共同确定分类边界。
- 核函数允许算法使用隐式特征空间,但不会消除样本规模带来的计算成本。
- 核方法、神经网络和注意力可以比较表示方式,不能当作同一种机制。
下一节: 2.7 决策树与随机森林