
5.1 预训练:从 Transformer 到语言模型
核心问题: Transformer 是通用序列架构,LLM 是怎么从它演化出来的?预训练为什么能让模型从无标注文本中学到知识?
在线 Notebook
对应的交互式版本可在 Google Colab 打开,统一使用方式见 第0章说明。
前置章节: 第4章:Transformer详解
从 Transformer 到语言模型
第4章介绍了 Transformer 的核心机制:自注意力、位置编码、残差连接。但 Transformer 本身只是一个序列处理架构,不天然是语言模型。
从 Transformer 到 LLM,需要三个关键步骤:
Transformer 架构
    ↓ 选择 decoder-only 结构(因果掩码)
    ↓ 定义自回归训练目标(预测下一个 token)
    ↓ 解决文字表示问题(Tokenization + Embedding)
GPT 风格的语言模型
    ↓ 大规模数据 + 大规模计算
LLM
Tokenization:把文字变成数字
神经网络只能处理数字,文字必须先转换为 token(词元)。
为什么不直接用字符或单词
字符级别: 序列太长,"hello world" = 11 个字符,注意力计算代价随序列长度平方增长。
单词级别: 词表太大(英语 50 万词),且无法处理新词、拼写错误、代码等。
BPE(字节对编码)
现代 LLM 使用 BPE(Byte Pair Encoding)在字符和单词之间找平衡:
初始:把文本拆成字符
      h e l l o   w o r l d

迭代:找最高频的相邻字符对,合并
      第1轮:'l' + 'o' 最频繁 → 'lo'
      h e l lo   w o r l d
      第2轮:'h' + 'e' 最频繁 → 'he'
      he l lo   w o r l d
      ...直到词表达到目标大小(如 50,000)
结果: 常见词变成单个 token,罕见词被拆成子词片段。
"unhappiness" → ["un", "happiness"]
"ChatGPT"     → ["Chat", "G", "PT"]
"def foo():" → ["def", " foo", "():"]| 词表大小 | 序列长度 | 覆盖能力 |
|---|---|---|
| 小(~10K) | 长 | 差(生僻词被拆碎) |
| 大(~100K) | 短 | 好(更多完整词) |
GPT-4 使用约 100K 词表,在序列长度和覆盖能力之间取得平衡。
Token Embedding:从离散符号到连续向量
Tokenization 把文字变成整数 ID(如 "cat" → 1234),但神经网络需要的是连续向量,不是整数。
Embedding 层
每个 token ID 对应一个可学习的向量,存储在 Embedding 矩阵 中:
词表大小 = 50,000,向量维度 = 4096

Embedding 矩阵形状:[50000, 4096]

"cat"(ID=1234)→ 取第 1234 行 → 一个 4096 维向量
这个向量是 token 的初始连续表示,在训练过程中和模型其他参数一起学习。它本身不包含当前上下文;经过 Transformer 后才形成上下文化表示。
训练后,部分语义或用法相近的 token 可能在向量空间中呈现可观察结构:
"cat"、"dog"、"kitten" 的表示可能比无关 token 更接近这种关系取决于 tokenizer、训练目标、数据和所观察的层,不能把单个 embedding 距离直接当作完整语义判断。
完整的输入处理流程
文本 → Tokenizer → Token IDs → Embedding 层 → Token 向量序列
                                                    ↓
                                            Transformer 层(注意力 + FFN)
                                                    ↓
                                            输出向量 → 预测下一个 token 的概率
输出端的投影层可以与 Embedding 矩阵共享权重(weight tying),从而减少参数量,并让输入嵌入与输出打分使用同一组参数坐标;它不保证二者学到完全相同的语义结构。
Decoder-only 架构
第4章提到了三种 Transformer 变体,LLM 为什么选择 decoder-only?
| 变体 | 代表模型 | 注意力方向 | 适合任务 |
|---|---|---|---|
| Encoder-only | BERT | 双向(看全文) | 理解:分类、NER |
| Encoder-Decoder | T5、翻译模型 | 编码器双向,解码器因果 | 翻译、摘要 |
| Decoder-only | GPT 系列 | 因果(只看左边) | 生成:续写、对话 |
训练目标天然统一: 只需预测下一个 token,不需要设计特殊的任务格式。
输入:The cat sat on the
目标:cat sat on the mat
每个位置都在做预测,整个序列都是训练信号,数据利用率极高。
生成任务的自然契合: 对话、写作、代码生成都是"给定上文,续写下文",decoder-only 的因果掩码天然匹配这个模式。
规模化更简单: 不需要维护编码器和解码器两套参数,架构更统一,更容易扩展到数千亿参数。
预训练:在无标注文本上学习
传统监督学习的瓶颈
任务1:需要 10 万条标注数据
任务2:需要 10 万条标注数据
任务3:需要 10 万条标注数据
标注数据昂贵,且每个任务的模型无法复用。
预训练的核心思想
用海量无标注文本训练一个通用模型,让它学会预测下一个 token:
降低这个目标的误差需要利用多类统计结构:
- 语法:哪些 token 序列常见且结构成立
- 语义:当前上下文与候选 token 是否相容
- 事实关联:训练文本中哪些实体和属性经常共同出现
- 任务模式:示例、问题和答案通常如何组织
关键点: 下一 token 预测提供了统一训练目标。为了降低预测误差,模型会学习语法、语义和训练数据中的统计关联;这些表示能否迁移到具体任务,仍需单独评估。
自回归生成
训练好的模型如何生成文字?
输入 prompt:["The", "cat"]
    ↓ 模型预测下一个 token 的概率分布
    P("sat") = 0.3, P("is") = 0.2, P("was") = 0.15, ...
    ↓ 采样
    选择 "sat"
    ↓ 把 "sat" 加入序列,继续预测
输入:["The", "cat", "sat"]
    ↓ 预测下一个...
每次只生成一个 token,然后把它加入输入,再预测下一个——这就是自回归(auto-regressive)。
| 采样策略 | 方法 | 效果 |
|---|---|---|
| Greedy | 每次取概率最大的 token | 确定但重复 |
| Temperature | 调整概率分布的"尖锐度" | 控制随机性 |
| Top-k | 只从概率最高的 k 个中采样 | 避免低概率词 |
| Top-p (nucleus) | 从累积概率达到 p 的词中采样 | 更自然 |
Scaling Laws:规模与训练损失的经验关系
幂律关系
OpenAI 2020 年的研究发现,模型性能与规模之间存在稳定的幂律关系:
其中
含义: 在研究覆盖的规模范围内,损失通常会随模型、数据和计算量增加而下降。但规模不是唯一变量,数据质量、训练配比、架构和优化稳定性都会影响最终效果。
最优计算分配:Chinchilla 定律
给定固定的计算预算,应该用大模型+少数据,还是小模型+多数据?
Chinchilla(2022)的结论: 在其研究设置和计算预算范围内,模型大小与训练 token 数需要共同扩展。常被引用的“每个参数约 20 个训练 token”是该研究设置下的经验量级,不是所有数据与架构的固定定律。
GPT-3:更大的参数规模、相对较少的训练 token
Chinchilla:更小的参数规模、更多训练 token

比较结论依赖固定计算预算和研究中的评测设置
实践影响: 后续许多模型更重视数据量和数据质量,而不是只扩大参数量。
指标上的非线性变化
当模型规模、数据量和训练质量变化时,有些离散评测会呈现跃迁:
In-Context Learning:
  模型对示例格式和任务规律的利用能力随训练条件变化

Chain-of-Thought:
  分步提示可能改变部分任务的准确率,但效果依赖模型和题型
连续能力被通过率等离散指标测量时,也可能看起来像突然出现。因此不能只凭参数阈值判断“涌现”,还要检查数据、提示和指标定义。
GPT 系列演化:作为训练路线案例
下面用 GPT 系列作为案例,理解 decoder-only、规模化、指令对齐和多模态如何逐步组合成现代 LLM。重点是演化逻辑,不是记住每个版本名。
2017  Transformer 论文(Attention is All You Need)
      — 提出 encoder-decoder 架构,用于机器翻译

2018  GPT-1(1.17 亿参数)
      — 第一个 decoder-only 预训练语言模型
      — 证明:预训练 + 微调 在 NLP 任务上有效

2019  GPT-2(15 亿参数)
      — 规模扩大 10 倍
      — 展示 zero-shot 任务迁移

2020  GPT-3(1750 亿参数)
      — 规模再扩大 100 倍
      — 展示 few-shot in-context learning

2022  InstructGPT / ChatGPT
      — GPT-3 + RLHF 对齐
      — 从"预测文字"变成"听从指令"

2023+ 多个模型系列继续扩展多模态、上下文和任务适配能力
GPT-1 到 GPT-3 保持了相近的 decoder-only 主干,同时扩大参数、数据和计算预算。实验结果不能只归因于参数量,因为数据组成和训练配置也在变化。
与第4章的连接
| 第4章概念 | 在 LLM 中的体现 |
|---|---|
| Decoder-only + 因果掩码 | GPT 的核心架构,保证生成时不看未来 |
| 位置编码(正弦) | LLM 用 RoPE(旋转位置编码)替代,支持更长上下文 |
| 残差连接 + LayerNorm | 使数百层的深层网络可训练 |
| FFN 层 | 对每个 token 的表示做非线性变换;部分研究用键值记忆作解释 |
代码实验
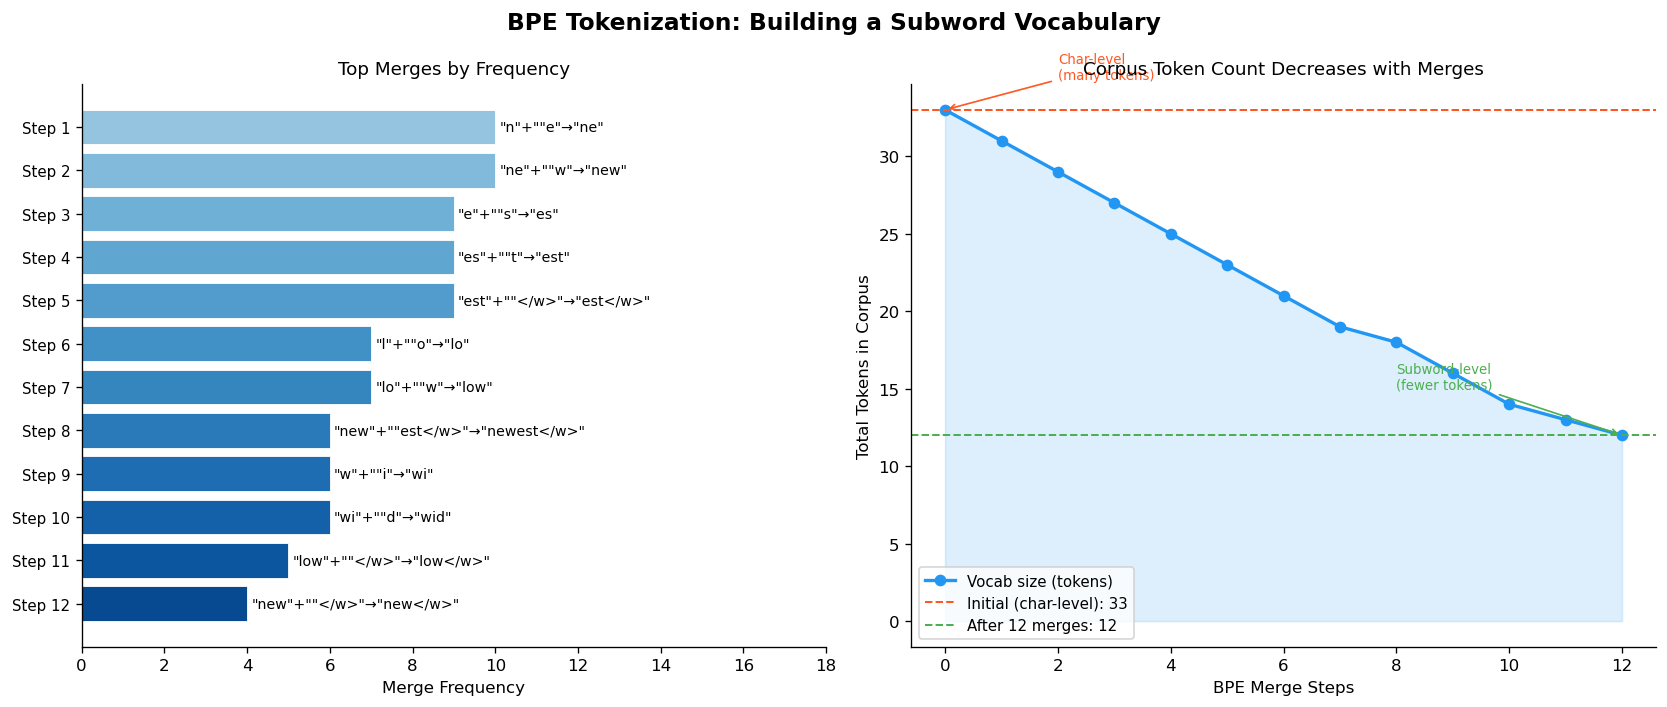
图5.1a:BPE 分词算法演示——词表构建过程与常见 token 的合并规则。
代码文件: code/ch05_llm_basics/bpe_tokenization.py
运行方式: python code/ch05_llm_basics/bpe_tokenization.py
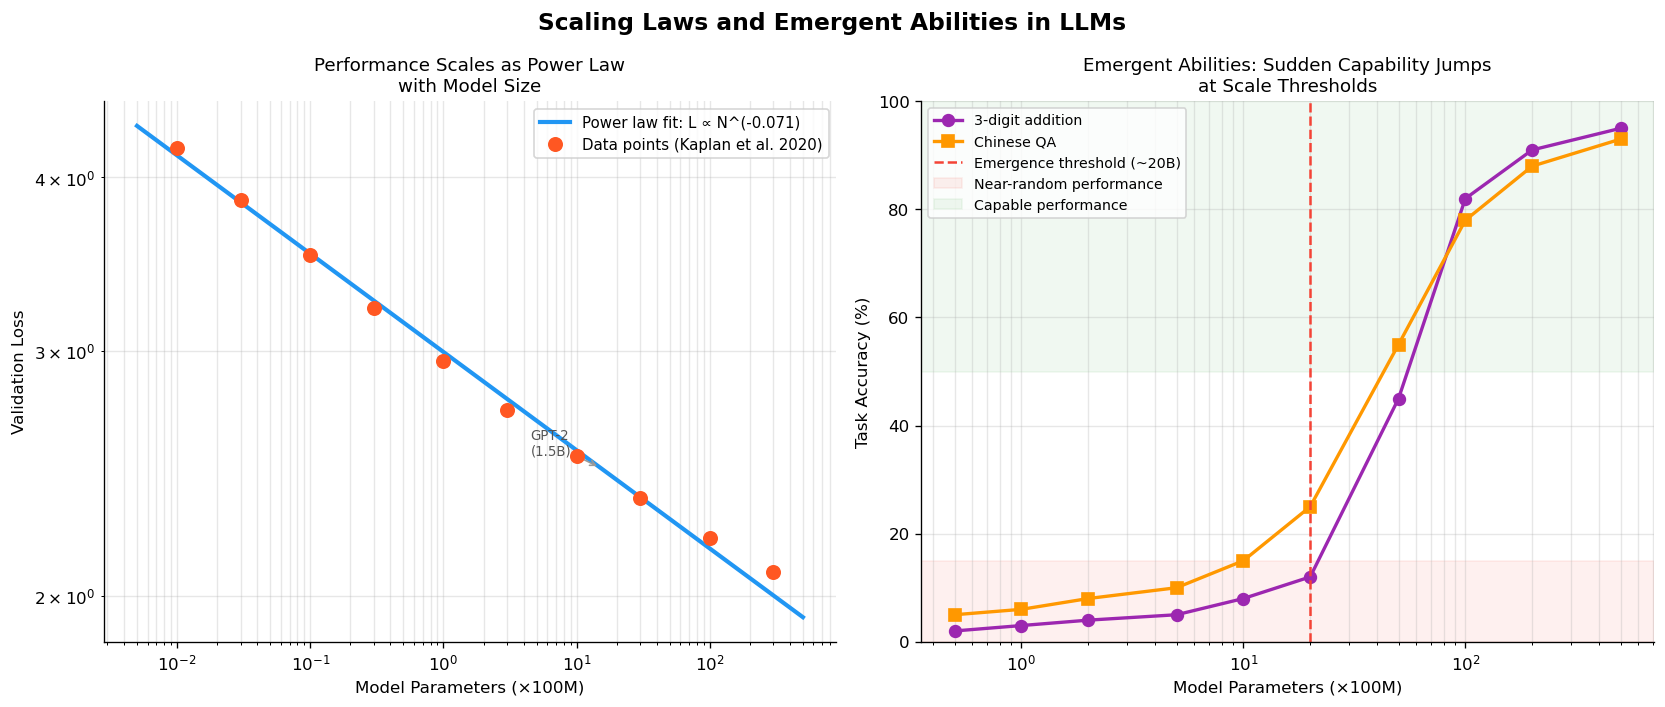
图5.1b:Scaling Laws 曲线——模型参数量、数据量与计算量对损失的影响,以及离散评测指标可能呈现的非线性变化。
代码文件: code/ch05_llm_basics/scaling_laws.py
运行方式: python code/ch05_llm_basics/scaling_laws.py
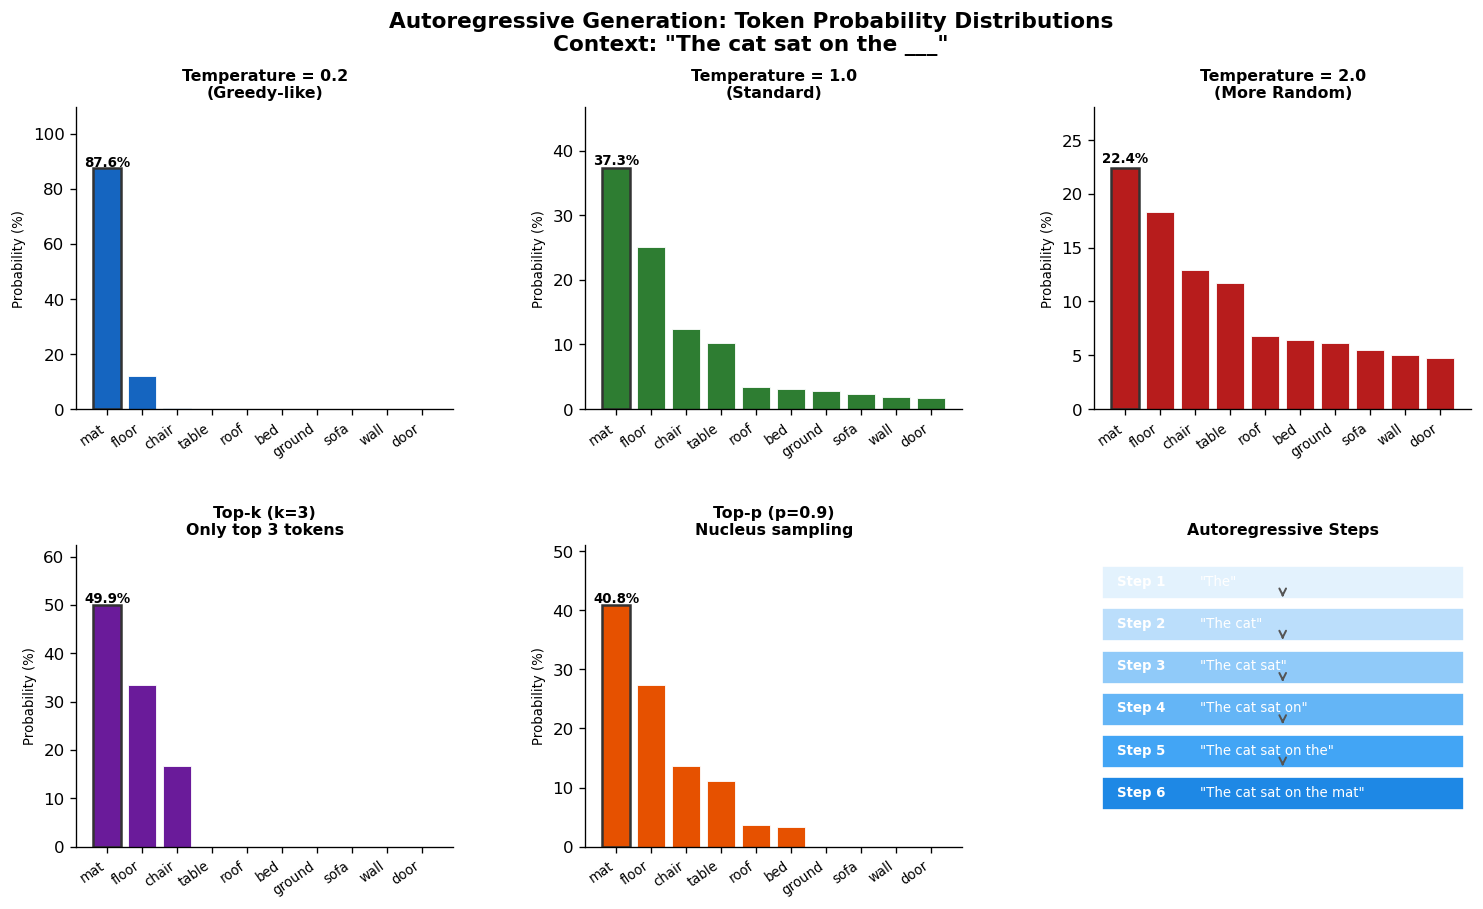
图5.1c:自回归生成过程——每步预测下一个 token 的概率分布,以及 temperature/top-p 采样对输出多样性的影响。
代码文件: code/ch05_llm_basics/autoregressive_generation.py
运行方式: python code/ch05_llm_basics/autoregressive_generation.py
本节小结
- Tokenization(BPE) 解决了文字到数字的转换,在序列长度和词表覆盖之间取得平衡
- Decoder-only 架构因训练目标统一、生成任务契合、规模化简单而成为 LLM 主流
- 预训练 用下一 token 预测学习文本中的语法、语义和任务模式,迁移效果需要按任务验证
- Scaling Laws 描述特定实验范围内规模与训练损失的经验关系,计算最优配置还取决于数据和训练方案
- 非线性评测变化 可能来自模型能力,也可能来自提示、数据和指标离散化,需要对照实验
下一节: 5.2 训练数据