
第 4 章:Transformer
本章沿一次前向计算解释 Transformer:输入如何表示、位置之间如何交换信息,以及 Mask 如何限制可见范围。
章节主图:输入表示经过位置编码、注意力、前馈网络、残差连接与归一化,得到上下文表示。
统一视角
text
token / 输入特征
  → embedding + 位置表示
  → QKᵀ / √dₖ 计算匹配分数
  → mask 限制信息流
  → softmax 权重聚合 V
  → 残差、归一化与 FFN
  → 上下文表示
注意力根据当前输入计算加权聚合,与固定卷积核不同;但它仍是矩阵投影、相似度和加权求和的组合。注意力权重可用于观察聚合位置,不等同于模型决策的因果解释。
小节目录
| 小节 | 需要回答的问题 |
|---|---|
| 4.1 自注意力 | Q、K、V、缩放和 Mask 分别做什么? |
| 4.2 多头注意力 | 多个投影子空间如何计算并合并? |
| 4.3 位置编码 | 没有递推或卷积时如何表示顺序? |
| 4.4 完整架构 | Attention、FFN、残差和归一化如何组成 block? |
可选预备材料:
与前后章节的连接
- 第 1 章的正弦基函数帮助理解固定正弦位置编码,但现代模型也会使用其他位置表示。
- 第 2 章的数值稳定性对应缩放点积、归一化和残差路径。
- 第 3 章说明多层网络如何学习表示;Transformer block 是一种具体的多层结构。
- 第 5 章在因果掩码下,把每个位置的上下文表示映射为下一个 token 的概率分布。
这些连接用于比较计算结构,不表示 DSP、CNN、RNN 与 Transformer 是单线替代关系。
本章学习闭环
- 沿主图标出张量在每一步的形状;
- 运行自注意力与因果掩码实验;
- 修改一个输入、维度或 Mask,保存修改前后的权重矩阵;
- 说明变化影响了表示、匹配分数、可见范围还是聚合结果。
最低实践任务
运行:
bash
python code/ch04_transformer/self_attention.py
python code/ch04_transformer/causal_mask_demo.py
改变一个 token 表示或 Mask 设置,比较两张注意力图。完成标准是能指出被屏蔽位置的权重如何变化,并说明输出为何随之改变。
代码实验
| 脚本 | 观察内容 |
|---|---|
self_attention.py | Q/K/V、权重矩阵与输出 |
scaled_attention_demo.py | 维度、分数方差与 softmax |
positional_encoding.py | 不同频率的位置表示 |
causal_mask_demo.py | 双向与因果可见范围 |
graph_theory_demo.py | 注意力矩阵的图结构视角 |
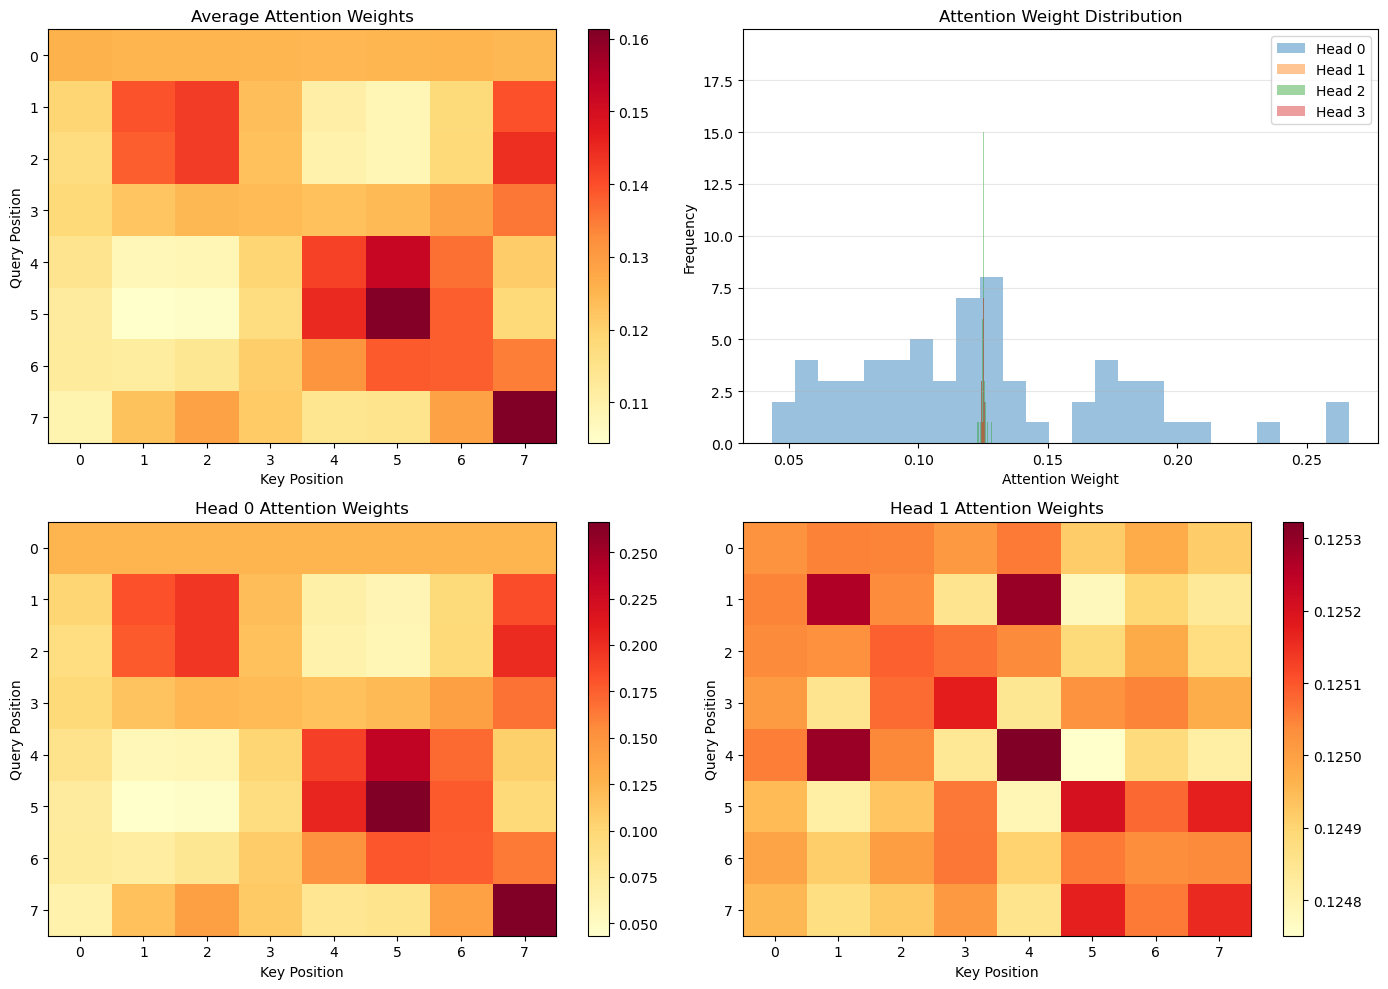
图4.1:每行表示一个 Query 对各 Key 的归一化权重。
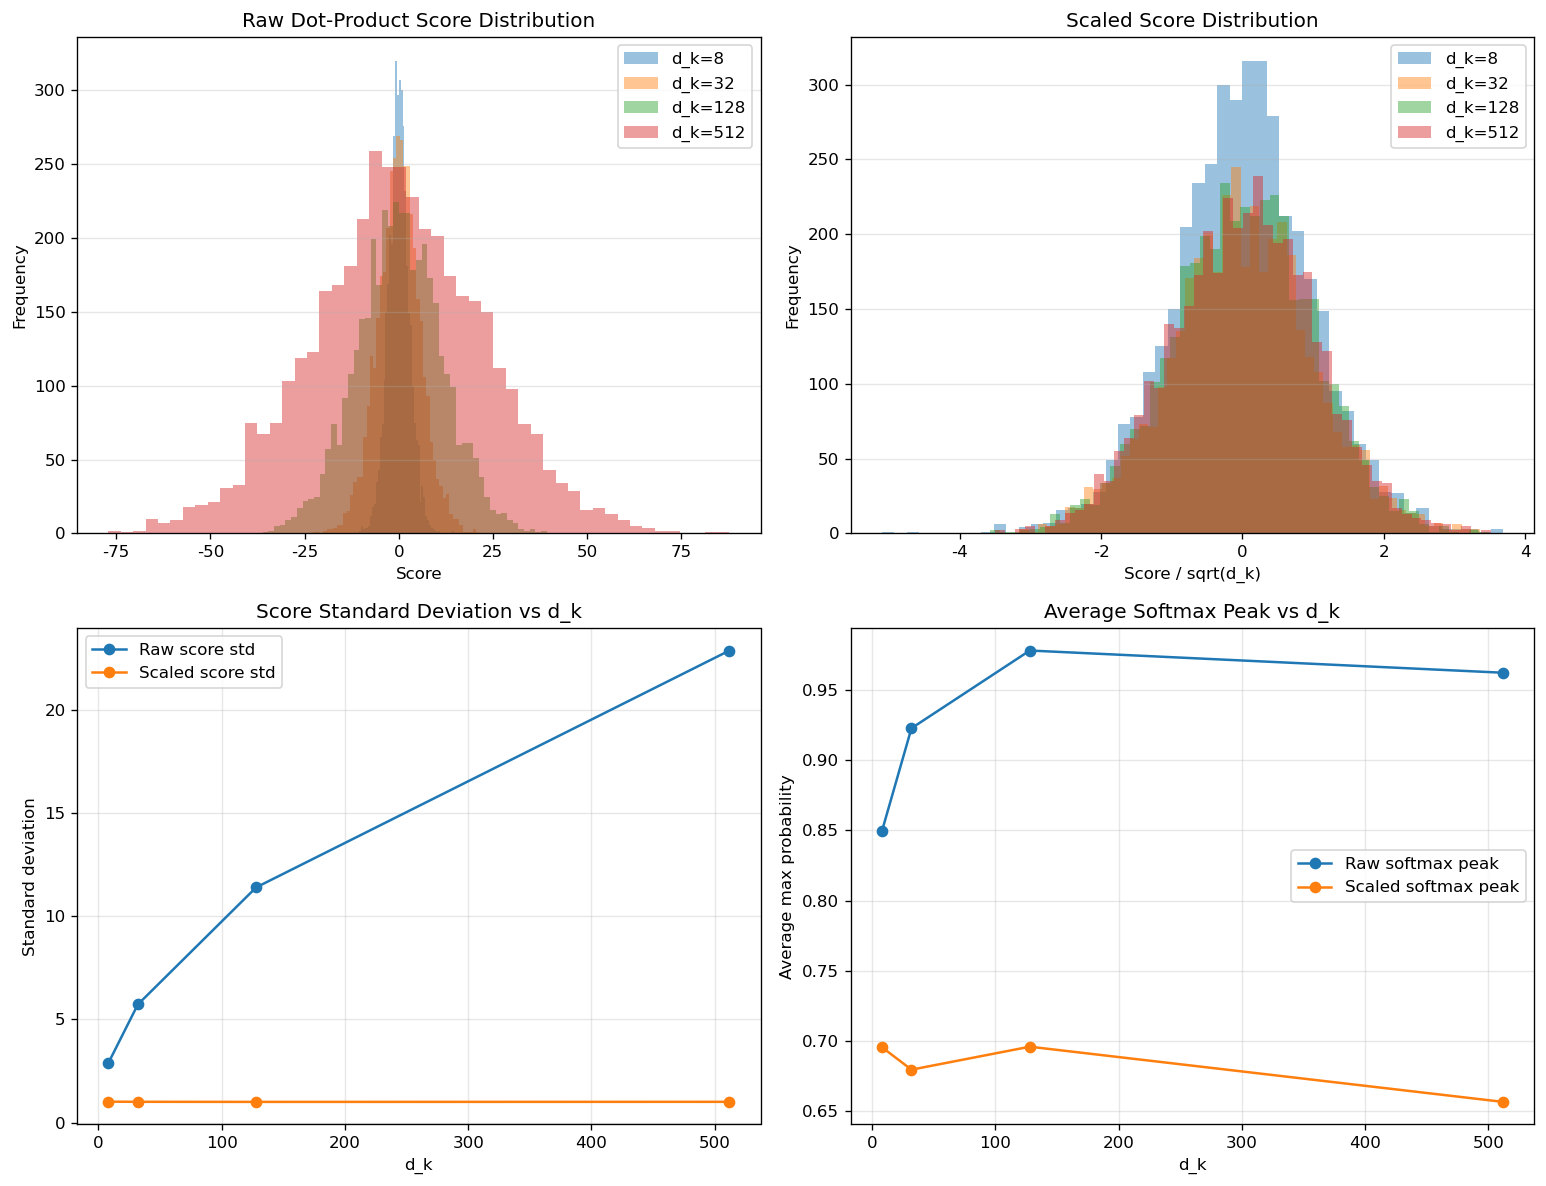
图4.2:缩放前后的点积分布与 softmax 权重。
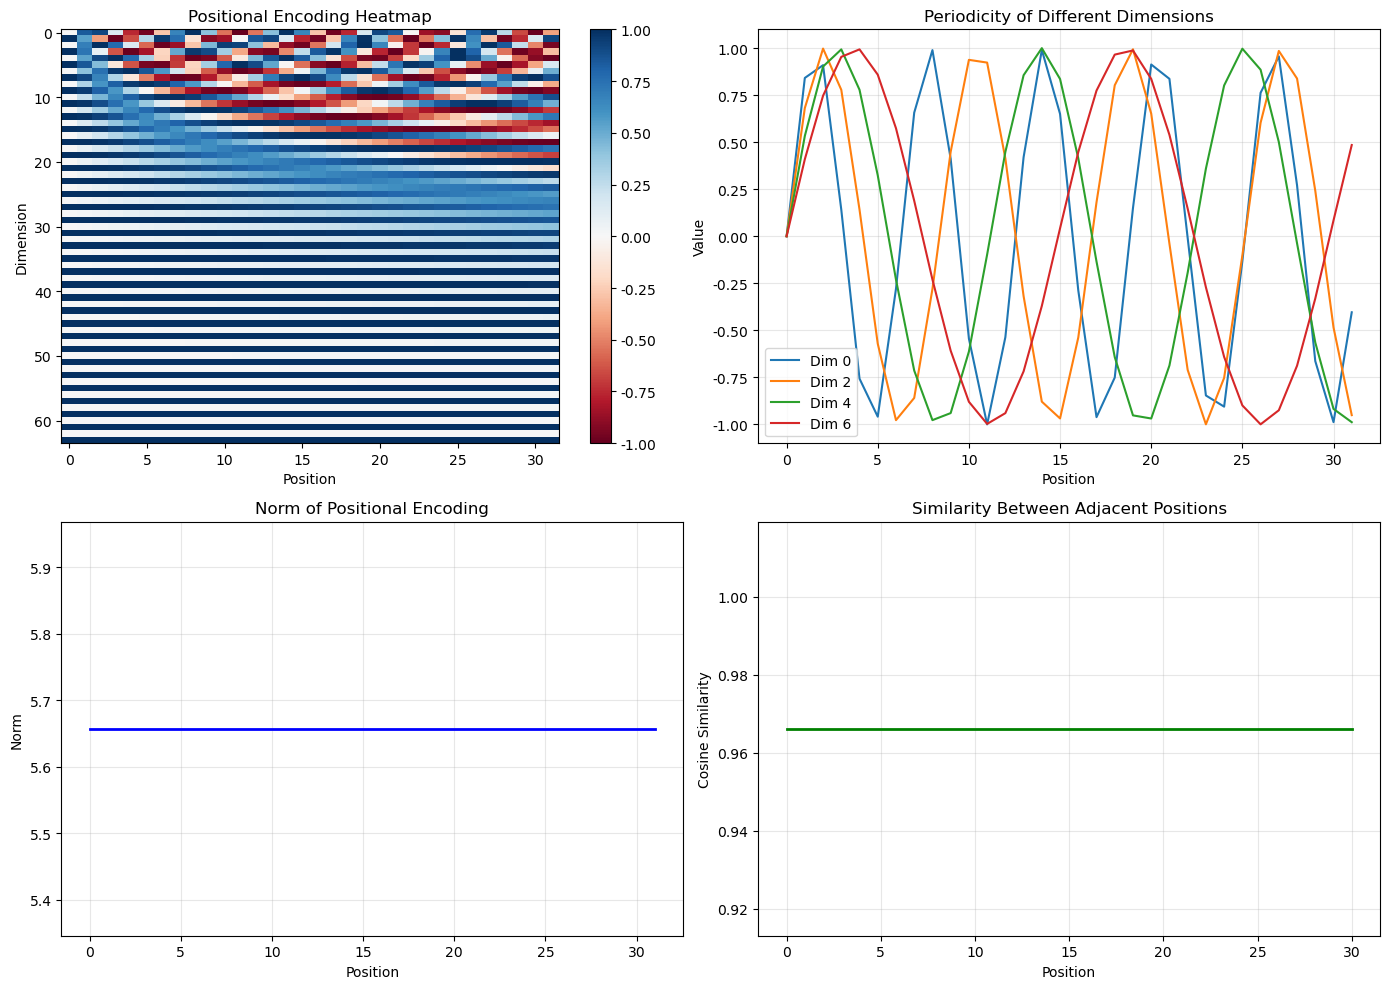
图4.3:固定正弦位置编码在位置与维度上的变化。
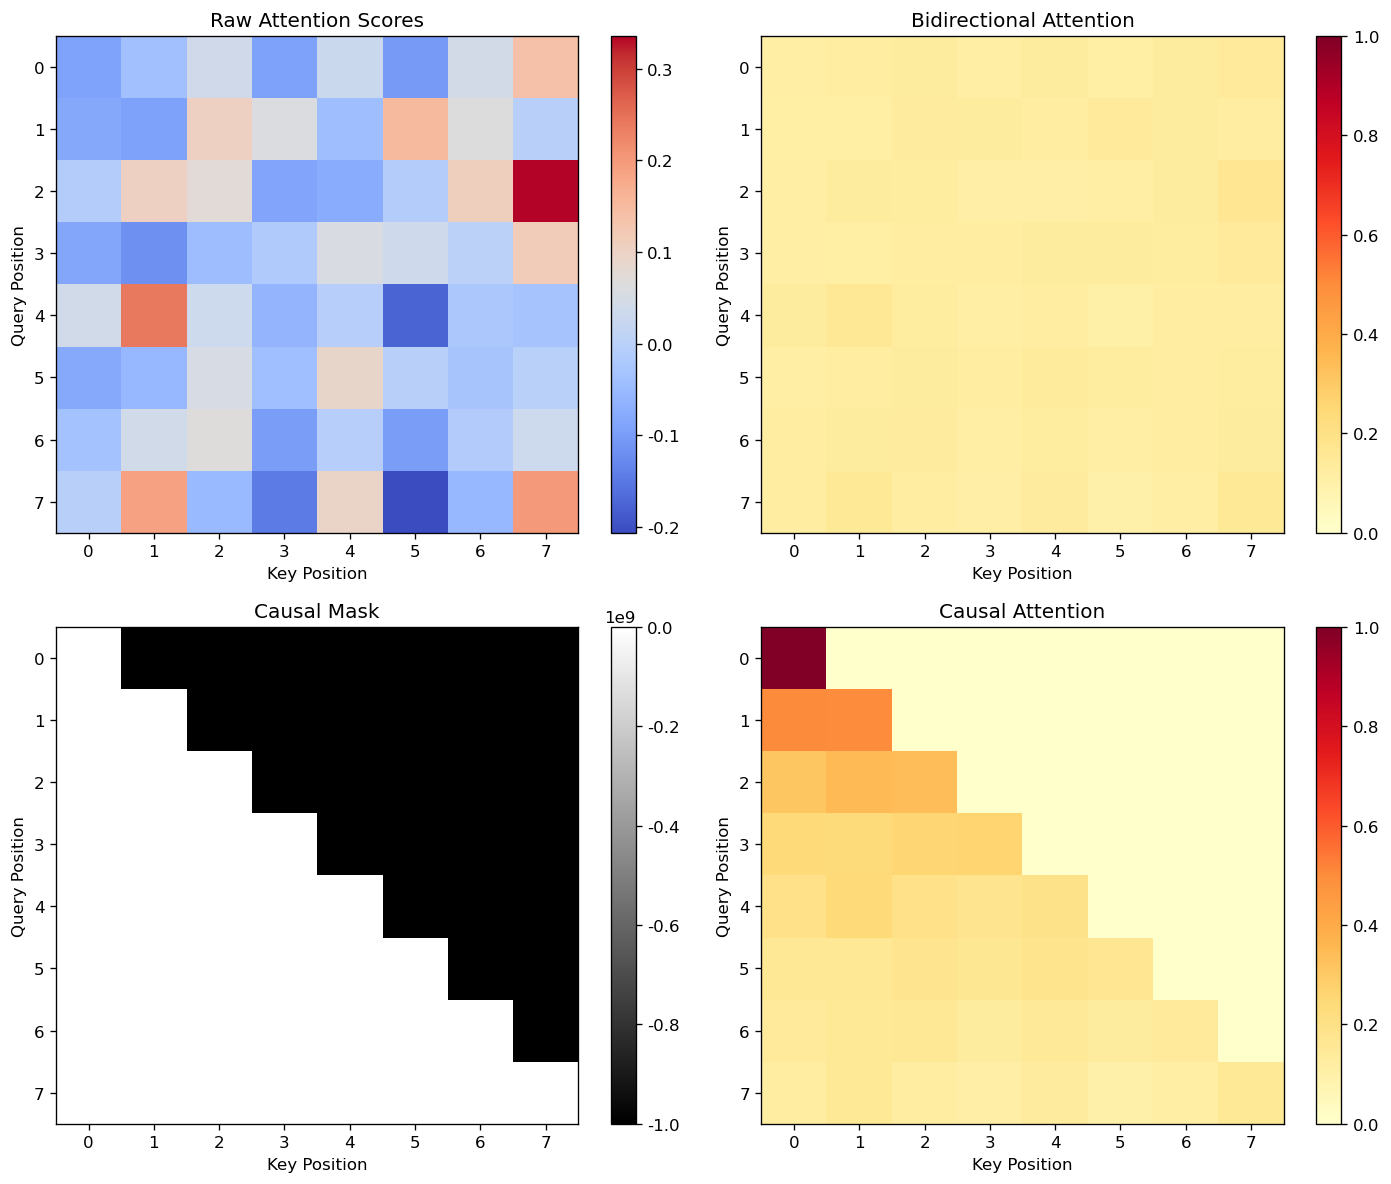
图4.4:因果 Mask 将当前位置之后的分数屏蔽,使生成位置不能读取未来 token。
下一步: 4.1 自注意力